商汤评测GPT-6-Astra:仿真近满分真机频失误
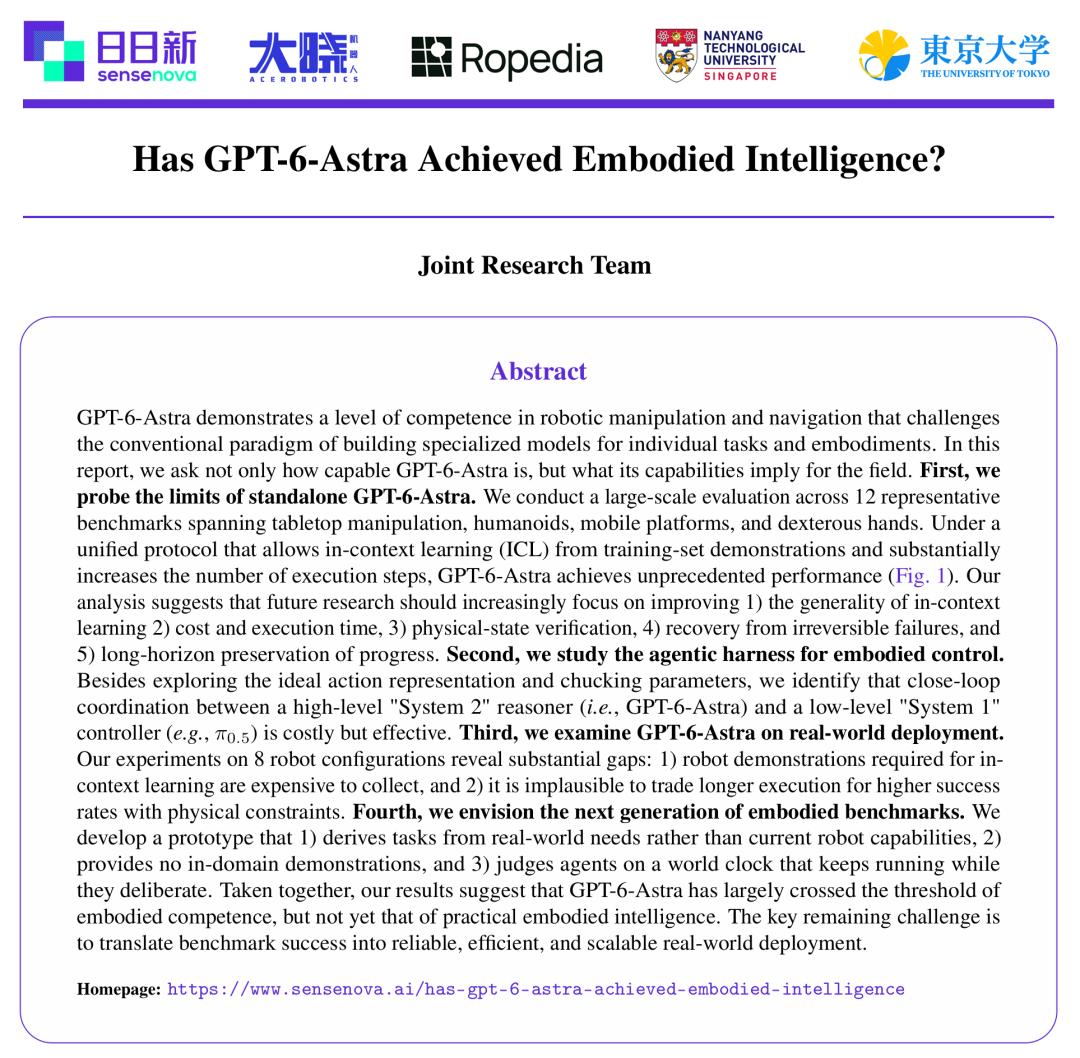
商汤SenseNova联合大晓机器人、Ropedia、新加坡南洋理工大学和东京大学团队发布报告《Has GPT-6-Astra Achieved Embodied Intelligence?》,对OpenAI的GPT-6 Astra进行覆盖12项仿真评测和8个真实机器人平台的系统评估。借助上下文学习与最多10倍动作步数预算,该模型在LIBERO-Long++上达到100%、LIBERO-Pro 99.3%、SIMPLE 98.8%,RoboDojo从标准预算的27.6%升至81.9%;但在家庭长程基准BEHAVIOR上仅37.0%,长程导航LHPR-VLN为28.9%。真机上刚性物体抓放18次成功17次,而插头插入任务在三个平台累计11次全部失败,把笔放进笔筒耗时4个多小时、花费55美元,煎蛋任务中判断已熟却约90秒后才关火致鸡蛋烧焦。报告结论是GPT-6 Astra已在很大程度上跨过具身门槛,但距离可实用部署仍有相当差距,并据此提出依靠执行反馈自我改进的SenseNova-RoboRSI框架。
报告指出,传统具身基准的高分与真机可靠执行之间存在明显落差,物理操作中的成功误判与难以撤销的后果是当前主要瓶颈,同时其提出的RoboRSI路线目前主要在仿真环境得到验证。
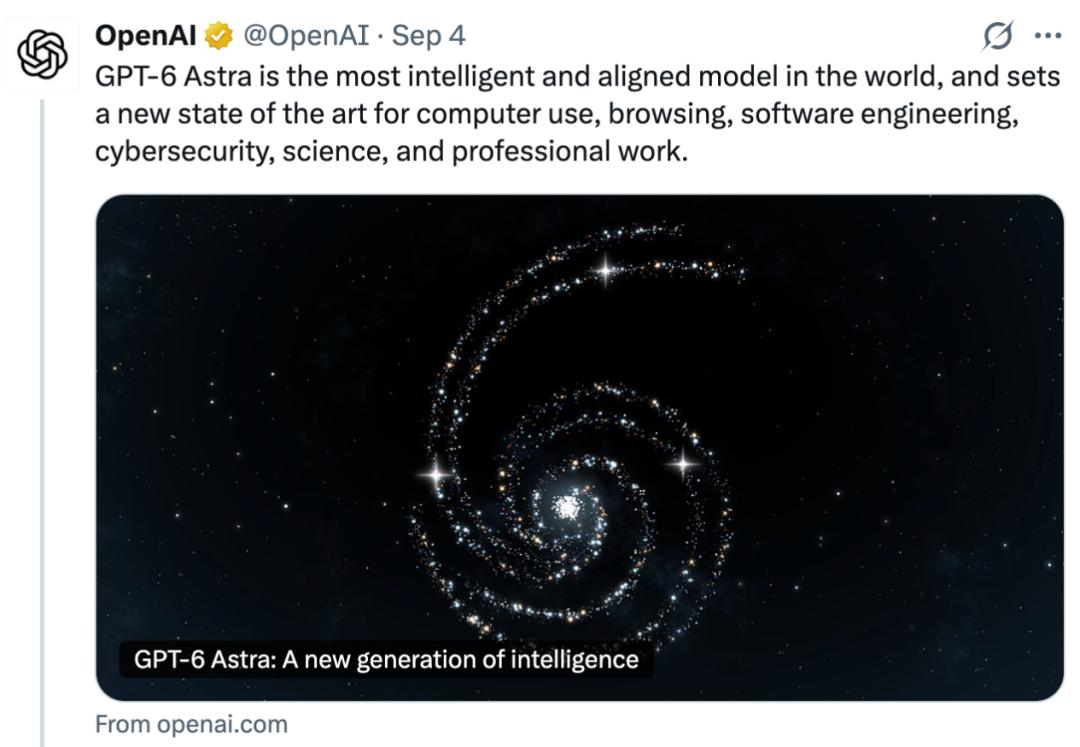
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
「GPT-6-Astra 的具身能力上限到底在哪?具身社区下一步最值得做的是什么?」
近日,商汤联合大晓机器人、Ropedia、新加坡南洋理工大学和东京大学的研究团队在《Has GPT-6-Astra Achieved Embodied Intelligence?》中,给出了覆盖 12 项仿真评测、8 个真实机器人平台的系统分析。
他们还分析了 GPT-6-Astra 与底层机器人控制系统的协作方式,搭建了一套更贴近真实家庭需求的具身评测原型。
#OpenAI#GPT-6 Astra#SenseTime#SenseNova#SenseNova-RoboRSI#Unitree G1#Franka 3#AgiBot G2#LIBERO-Long++#DexJoCo#RoboDojo#NVIDIA Isaac Sim