HengHan Micro raises nearly RMB 100M angel round for 400G RDMA smart NICs
In August 2026, Chengdu-based AI networking chip startup HengHan Micro said it closed a nearly RMB 100 million angel round led by a group of Chinese investors including Beijing Guotai, Chengdu Sci-Tech Investment, Chengdu Hi-tech Venture Investment and CITIC Juxin Investment, with proceeds going to product iteration, hiring and market expansion. Its first product, a 400G RDMA smart NIC, has completed sampling and validation and received formal orders, with initial customers being small and mid-sized model training/inference firms and AI token factories; the card uses an FPGA design for faster market entry. The company claims its in-house RDMA architecture with credit-based proactive congestion management achieved dynamic latency one-half to one-third that of NVIDIA's comparable CX-7 in some test scenarios, and plans to move to in-house ASIC chips for next-generation 800G and 1.6T cards.
Why it matters: High-end RDMA NICs are largely supplied by overseas vendors, so domestic alternatives like this could affect both the interconnect supply chain and effective utilization of AI compute clusters.
 2026年8月,AI智算网络互联芯片设计企业成都恒瀚微电子有限公司(以下简称“恒瀚微”)宣布完成近亿元天使轮融资。本轮投资方包括北京国泰、成都科创投、成都高新创投和中信聚信投资,资金将用于产品迭代、人才引进和市场拓展。
大模型正在把GPU集群越做越大,GPU之间的数据传输效率也开始影响算力利用率。负责服务器高速通信的RDMA智能网卡,是智算集群的关键连接设备。
但高性能RDMA智能网卡长期由海外厂商主导。行业资料显示,英伟达ConnectX系列网卡在AI智算场景中的市场份额达到95%;受出口管制影响,以CX7为代表的高端产品对华供货周期已延长至平均6个月,国产替代需求日益迫切。
成立于2024年的恒瀚微,瞄准的正是这一国产替代缺口。
其首款400G RDMA智能网卡已完成送样和验证,并拿到正式订单。产品通过自研RDMA架构和主动拥塞管理方案,在大量数据集中涌入前提前控制流量。恒瀚微创始人兼CEO胡超博表示,在部分测试场景中,首款400G RDMA智能网卡的动态时延远低于英伟达同类产品(CX-7)。

锚定AI算力刚需,打造RDMA网卡
胡超博是科班出身,专业学的就是芯片,在海外学成归来,一直做网络芯片研发,曾在中兴微电子、奕行智能工作。胡超博一直有自己创业的想法,一边工作攒经验,一边寻找行业内创业的机会。
 胡超博
芯片行业,信奉的是长期主义。胡超博抱着这样的心态,寻找着一个属于自己的创业机会,一等就是四年。
他曾研究过2020年大火的DPU(Data Processing Units数据处理器)。当时,英伟达把DPU、CPU、GPU统称为“未来计算三大支柱”,国内也迅速掀起一轮DPU创业浪潮。DPU专门接管服务器的网络、存储、加密等杂活,帮CPU减负,让算力更多留给业务运算,主要用于云计算场景。
但最后,胡超博没有下场做DPU。
原因在于,不同云计算客户对DPU的需求差异较大,产品往往需要定制,同一款DPU能够覆盖的客户有限。“而芯片或者以芯片为核心的产品一定要有比较强的通用性,销售量要足够大。因为做流片需要很多资金,需要极大的出货量去摊薄成本,公司才会真正有利润。”胡超博说。
真正促使胡超博创业的,是大模型出现后算力端发生的变化。
2022年之后,GPT-3引发的大模型涌现。随着大模型参数量的飙升,大模型训练和推理所需要的GPU也在指数级飙升。胡超博表示,随着GPU卡的数量增加,网络带宽和延迟的痛点,会极大限制GPU之间的数据传输效率,从而影响算力。
大模型训练过程,每一张GPU并不是单兵作战的。大模型训练会把任务进行拆分,每个GPU都会领取各自的计算任务,完成后将计算出的数据传输给下游的GPU,进行后续计算。只要一部分数据没有按时到达,下游的其他GPU就要等待。
因此,GPU之间数据传输效率,也成为了限制算力的因素之一。
而RDMA(远程直接内存访问)智能网卡则是解决这一问题的设备。其中,RDMA是一种服务器高速通信技术,可以让一台服务器的数据更直接地进入另一台服务器的内存,减少数据搬运造成的等待。RDMA智能网卡安装在GPU服务器中,负责将本机GPU产生的数据发送到其他服务器,同时接收其他GPU传送来的数据。
胡超博认为,RDMA智能网卡正是那个适合自己的机会点,有两方面的考量。
一是市场需求分析,智能网卡需求本身就很大,GPU和智能网卡配置是1:1,而如今GPU集群正在扩容,这本身就会带来相应的大量智能网卡需求。另一方面,供给侧存在缺口。从2022年起,大模型和GPU集群快速发展,但400G以上的RDMA智能网卡仍主要由海外厂商提供。RDMA智能网卡存在着国产替代的迫切需求。
二是产品角度分析,RDMA智能网卡是一个技术壁垒较高的标准化产品。网卡本质上都是解决高带宽、低时延和流量管控问题。但是RDMA智能网卡起步就要做到400Gbps,在带宽、时延和流量管控都要做到极致,其技术壁垒相对较高。
而胡超博自己一直从事的都是网络芯片研发工作,本身就积累了不少相关的研发经验。
同时,他还联系了曾经的老同事,组成一支15人的初始团队。这些人也一直从事网络芯片相关的工作,分别来自中兴微电子、华为海思、阿里巴巴、腾讯等头部科技企业的一线。有了他们的加入,团队具备全链条能力,覆盖芯片架构设计、芯片实现、网卡开发、产品工程化、商业化等环节。
2024年,胡超博创办恒瀚微电子,瞄准RDMA智能网卡创业。

自研拥塞管理,400G网卡实现性能突破
历经一年多的打磨,恒瀚微于2025年就推出首款产品400G带宽RDMA智能网卡。
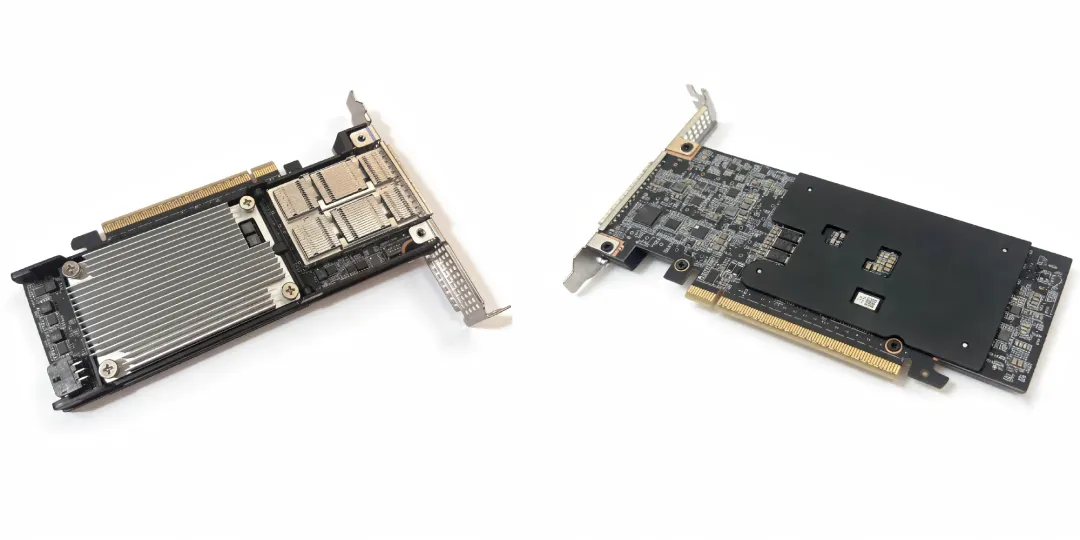
400G RDMA智能网卡
恒瀚微之所起步就做400G,是因为400G是目前AI智算中心跨服务器通信的主流带宽规格之一,可以快速进入已经形成需求的市场。胡超博表示,从2022年开始,400G网卡已经大范围应用于GPU集群,相关GPU、交换机和客户测试环境都较为成熟。
恒瀚微首款产品的差异性,还体现在解决了拥塞状态下的带宽稳定和动态时延等问题,这都是业内长期存在的痛点。
因为大模型训练过程中,常常会出现GPU“多打一”现象,即多张GPU可能同时向一张GPU发送数据。大量流量集中进入接收端,网络会出现拥塞。数据开始排队后,传输时延上升,带宽发生波动,等待数据的GPU也无法继续计算。
围绕这一问题,恒瀚微自研了RDMA架构,并将其与credit-based主动拥塞管理方案结合。
其中,Credit可以理解为接收端向发送端发放的数据传输额度。发送数据前,发送端先向接收端提出请求;接收端根据自身能够处理的数据量,向发送端发放相应额度;发送端获得额度后,再开始传输数据。
这是恒瀚微与传统方案的最大区别。
传统方案通常在网络已经出现拥塞后再进行调节。恒瀚微的方案则将流量管理提前到拥塞发生之前,由接收端决定允许多少数据进入。“这相当于提前做管控,避免大规模拥塞。”胡超博说。
这个方案,让恒瀚微的产品具有两重功能优越性:一是提高拥塞场景下的带宽稳定性。接收端提前控制进入的流量,可以减少大量数据同时涌入造成的排队和波动。
二是降低动态时延。动态时延是指网络负载不断变化时,数据从一端传输到另一端实际需要的时间。胡超博透露,在部分测试场景中,恒瀚微400Gbps网卡的动态时延可以达到英伟达同类产品的1/2至1/3。
除此之外,恒瀚微还在网卡中加入了可编程队列。队列是网卡内部等待处理的数据通道,可编程意味着客户可以根据不同任务,调整部分流量的处理方式。对智算中心的运维人员而言,这意味着他们能够实现更可控的网络管理,观察不同任务的数据流量,并定位网络拥塞和性能异常发生在哪个环节。
在产品实现上,恒瀚微采用FPGA。FPGA是一种可以反复编程、调整功能的芯片,开发和修改速度较快。客户提出新需求后,研发团队可以直接调整部分功能,缩短产品适配周期。“我们希望能够快速切入市场,先锁定一些客户。”胡超博表示。在客户验证过程中,团队也能进一步了解真实业务需求,再针对这些需求设计后续的产品。

首款产品拿下订单
布局下一代智算互联生态
目前,恒瀚微400G RDMA智能网卡已经完成了送样和验证,拿到了正式订单。
第一批客户主要是中小规模的模型训练、模型推理企业,以及AI Token工厂。这些企业会直接采购网卡,将其安装在GPU服务器中,主要用于Scale-up网络业务场景。
从送样到PoC,恒瀚微用了三个月时间。测试规模从双卡逐步增加到4卡、8卡、32卡和128卡,包括产品功能测试,以及复杂流量下的稳定性测试。经过这一过程,恒瀚微实现从研发到订单的商业闭环。
对恒瀚微来说,这只是商业化的第一步。更难的是,如何让现有产品抓住市场需求,又让下一代产品在需求切换之前完成研发。
AI网卡需要与GPU、交换机以及智算中心的建设周期相匹配,一代网卡产品的市场周期大约为3-4年。以400Gbps网卡为例,其从2022年开始大规模应用,到2026年仍有大量的市场需求。
但网卡用的芯片研发必须走在市场前面。“从芯片行业来说,要提前一代去研发。因为研发预期和市场会有差异,所以要留够足够的buffer(研发进度与市场需求之间预留的缓冲时间)。”胡超博表示,“我认为buffer刚好可以卡在半代到一代的时间点上。”
因此,恒瀚微将一代产品的研发周期控制在1.5年左右。
在首款400G网卡产品的研发上,胡超博采取加速切入市场的策略,并没采取自研ASIC芯片,而是先采用可以反复编程、快速调整功能的FPGA方案,希望用400G网卡快速切入市场,拓展不同类型的客户,形成更为多元的客户结构。
在二代产品800G和1.6T网卡上,恒瀚微将采用自研的ASIC芯片。ASIC是针对特定功能设计的专用芯片,研发投入更大、周期更长,但在性能、功耗和成本方面更适合规模化量产。“我们把目光放得更远,800G网卡和1.6T网卡才是未来。”胡超博说。
在胡超博的设想中,恒瀚微将网卡产品做到逐步从Scale-up场景向Scale-out场景延伸。其中,Scale-up是先把几十颗GPU组成一台“超级计算机”,Scale-out是再把许多台“超级计算机”连成算力集群。
未来3-5年,胡超博希望在400G网卡取得市场突破的基础上,进一步推出更高带宽的下一代产品800Gbps和1.6Tbps网卡,抢占AI智算Scale-out互联市场。其中,800G网卡产品主要面向国内市场,1.6T网卡产品计划进入东南亚等海外智算中心。
在此基础上,胡超博和恒瀚微还会探索Scale-mix场景,尝试用一套融合架构连接Scale-up和Scale-out两层,让GPU内部组网与集群之间的网络能够在同一套架构下协同。
“未来我们会构建Scale-mix的新生态。”胡超博说,他希望用一套架构兼顾GPU之间和算力集群之间的连接,减少不同网络之间的适配,让算力扩容和管理变得更高效、更简单。
How we got here
- Musk builds chips, Zuckerberg farms cells as AI races for new means of production虎嗅 AI · NVIDIA
- Innolight's triple bind as optical modules become a policy flashpoint虎嗅 AI · Nvidia
- Trump announces 'AI Force' and an AI czar虎嗅 AI · Nvidia
- Citi: Meta Muse agents could shift CPU-GPU ratios toward 1:136氪 人工智能 · Nvidia
- AI bubble debate: Dalio warns of burst, Novogratz says it's still early36氪 人工智能 · Nvidia
- Over $3B floods into 'physical AI' for science as AI drug discovery hits limits36氪 人工智能 · NVIDIA