Lev复用权重,通过重复计算加深决策
里海大学等机构研究者提出决策模型Lev,以重复计算而非生成token来增加推理深度。据研究作者介绍,Lev用同一组权重支持多个计算深度,并由轻量停止机制决定运行多少轮。模型在每轮后读出候选项概率,各轮联合训练。在公开的231题JevBench上,同一个Lev-2.6B checkpoint的项目记录显示,一轮准确率为63.2%,四轮为76.2%,在checkpoint权重不变的情况下提高13.0个百分点。报道说明,这些数字是按项目主页记录重绘的回放实验数据,并非实时推理结果。
Lev提供了一种用同一组权重控制决策深度的开源方案,并可让需要更多计算的题目运行额外轮次。报道将其架构描述为“System 1.5”式设计,在保留直接决策接口的同时,允许较难题使用更深计算。报告还称,使用k轮时只需计算前k轮;但相关基准数字来自项目记录,而非实时推理结果。
11月2日消息,近日,来自美国宾州里海大学 Lehigh University 等机构的研究者提出 Lev,一个用循环而不是 token 来加深思考的决策模型。Lev 在每一圈之后都读出一次选项概率,各圈联合训练,所以同一份权重可以在任意深度作答;一个轻量的停止器再按题目决定算几圈。
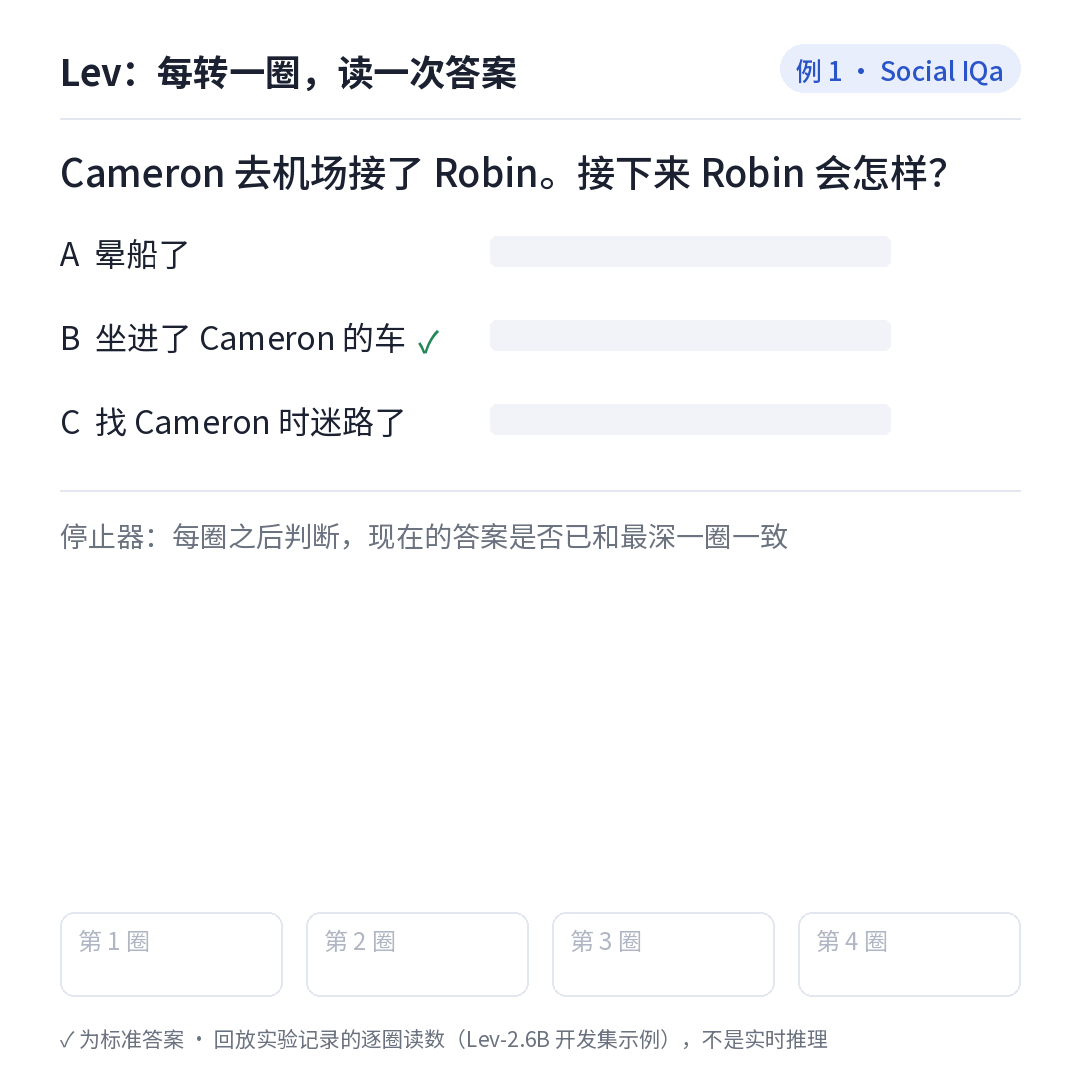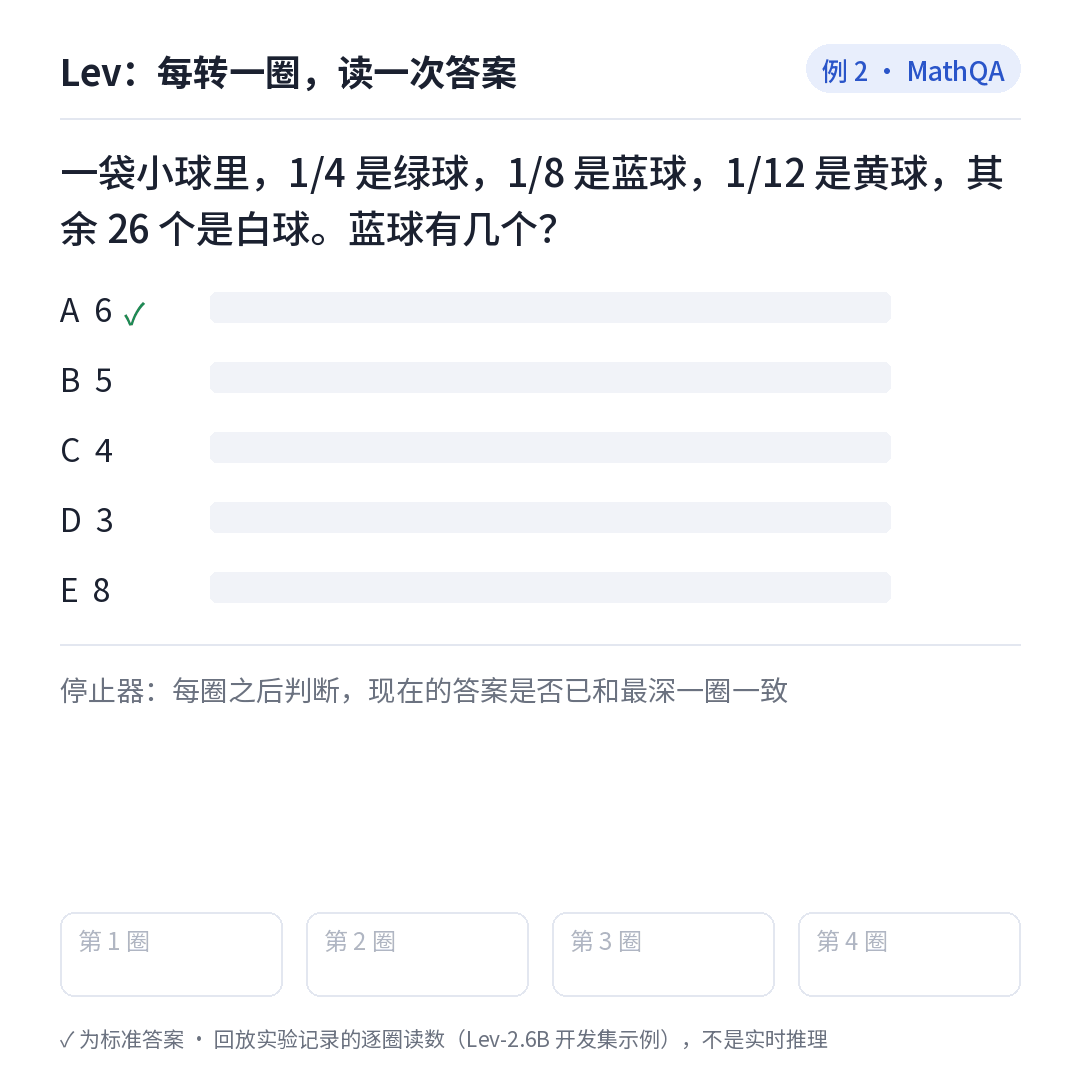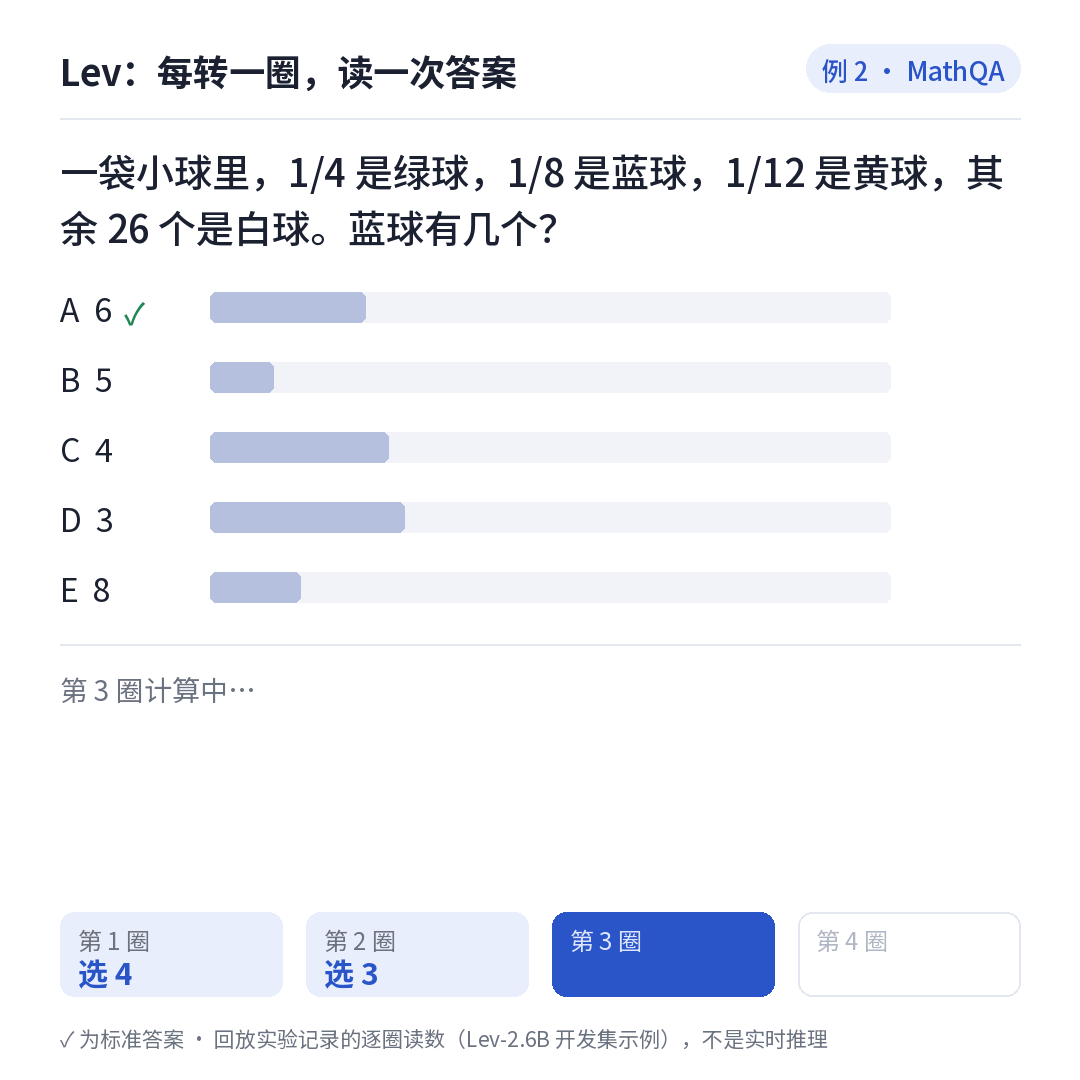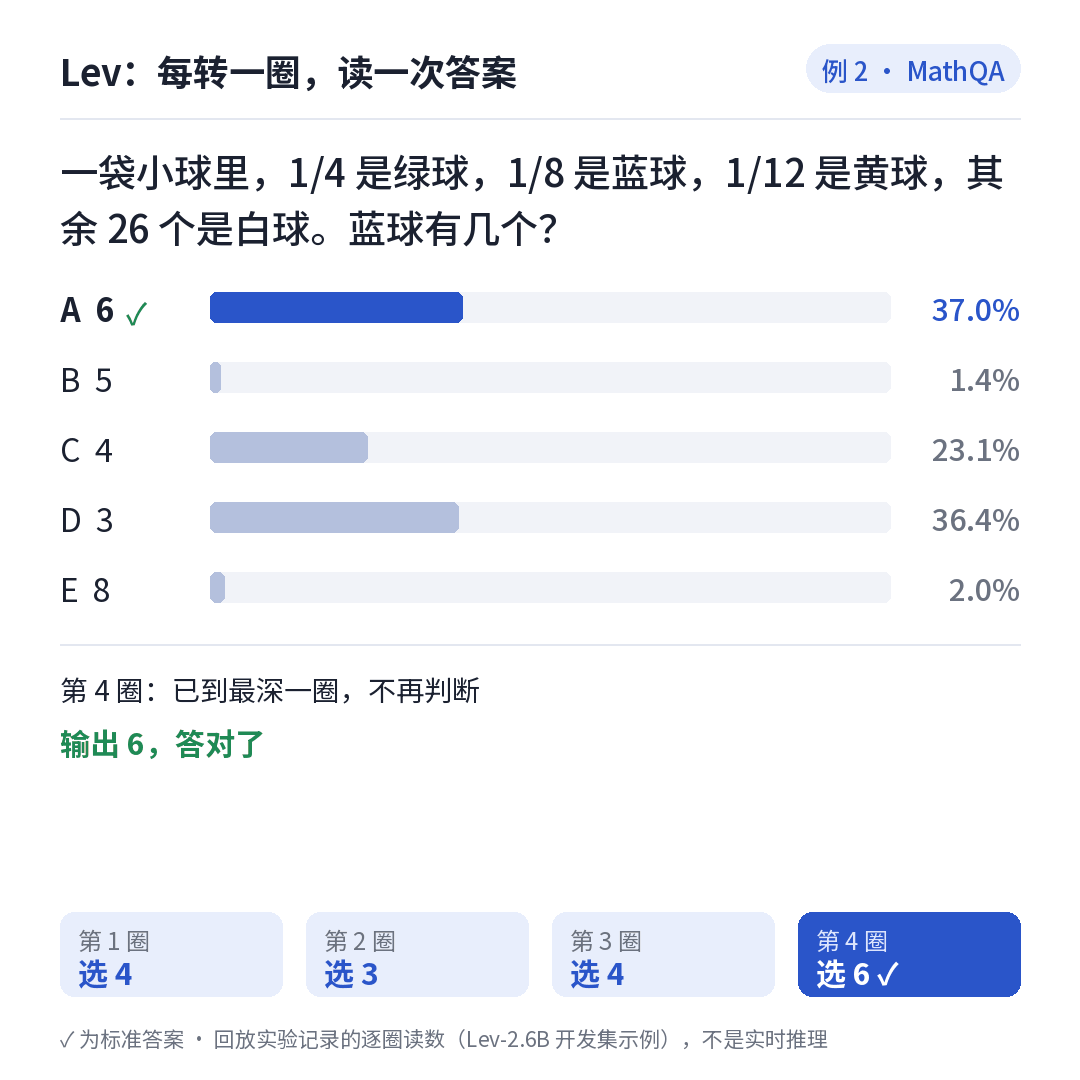
作者把这种计算方式称为 System 1.5 :保留 System 1 直接给出决定的接口,又能像 System 2 一样在难题上多花计算。
Lev 逐圈作答(按项目主页记录的逐圈读数重绘,回放实验数据,不是实时推理):例 1 第 1 圈就选中正确答案 B,停止器判定可以停下;例 2 第 1 圈选 4,到第 4 圈改选正确答案 6。
从任务形态看,Lev 可以视为 OpenAI Decisions 式文本决策的一个独立开源实现,并多了一个「深度旋钮」。这里的「式」只指任务形态:给定输入和候选项,输出每个选项的概率。Lev 基于公开的 Ouro、Nanbeige 底座和 Kev 实现,不复刻 OpenAI 的模型权重、内部架构或 API,也没有与其产品做性能对测。
#Lev#Lehigh University#Ouro#Nanbeige4.2#Kev#JevBench#OpenAI Decisions