
AMD to buy World Labs for $8.2B in all-stock deal
An analysis republished by 36Kr says AMD announced on Sept. 28 an all-stock acquisition of World Labs valued at $8.2 billion, expected to close by the end of 2026 pending regulatory approval, with Fei-Fei Li set to become an AMD executive vice president reporting to Lisa Su. The piece cites NVIDIA's roughly $12.9 billion purchase of Hugging Face, Qualcomm's acquisition of Modular and SpaceX's acquisition of Anysphere as signs chip giants are moving into the model layer. For Chinese chip makers such as Moore Threads and Huawei's Ascend, it argues that partnerships with world-model teams — rather than acquisitions — are the more realistic route, currently progressing from proving models can run to sharing in hardware definition.
Why it matters: The deal is being framed as a sign that compute vendors are shifting from selling capacity to shaping how next-generation AI models define hardware requirements.
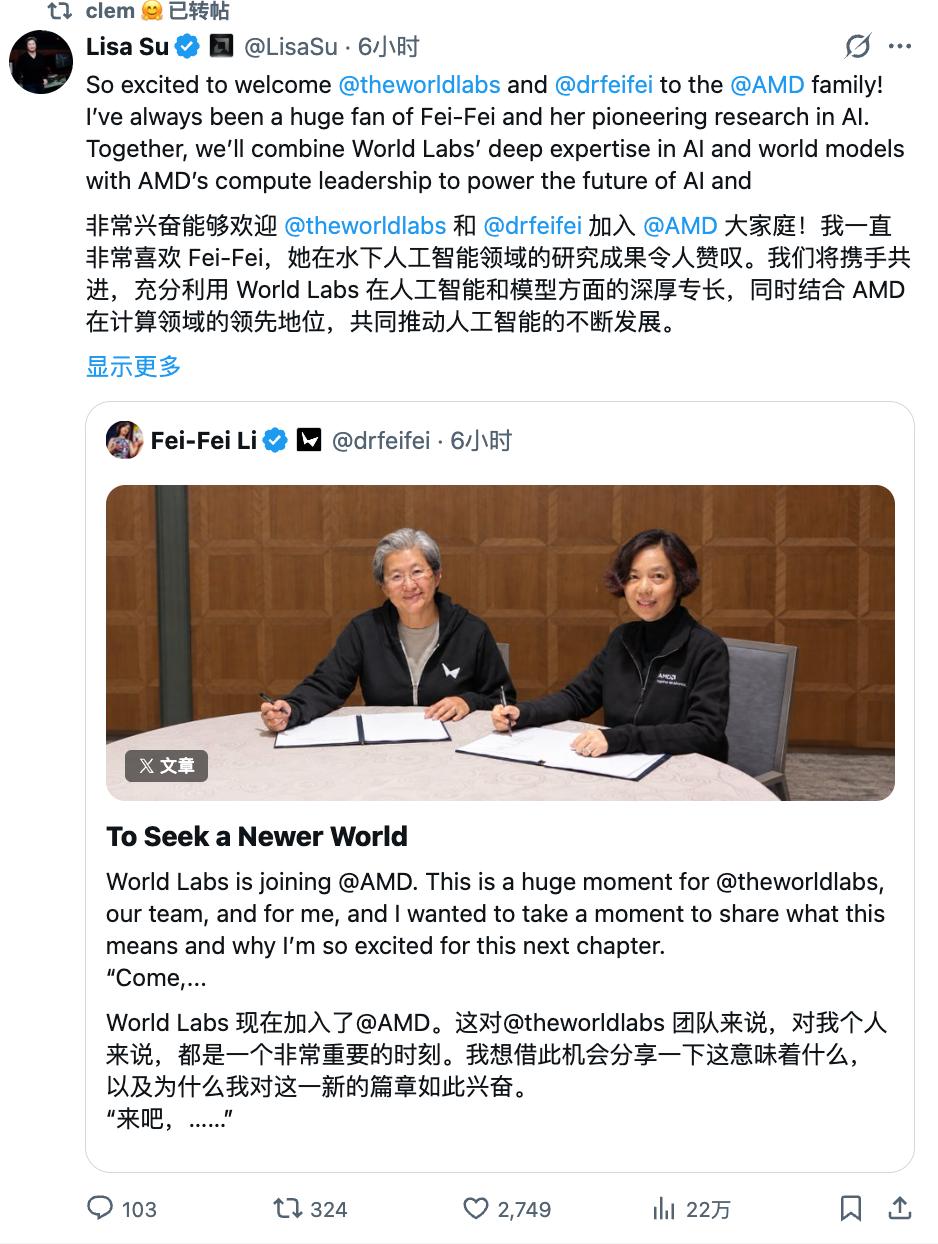
9月28日,芯片巨头AMD宣布以82亿美元全股票交易收购World Labs,该公司成立仅两年多,员工约70人,首款商业产品Marble上线不到一年,新一代模型Atlas在这宗交易宣布前发布不到一个月。
消息公布当天,AMD股价收跌3.61%。市场在疑虑什么?一个没有收入、技术路线尚未收敛的实验室,凭什么值82亿美元,这笔账怎么算出来的,有人甚至认为这是一场利益输送。
2026年1月CES上,苏姿丰把李飞飞请上主题演讲的舞台,两人同台展示World Labs的产品,那时候,苏姿丰是World Labs的早期投资人,李飞飞是创业者。
九个月后,这段投资人与创业者关系直接升级成了CEO与首席科学家,李飞飞将出任AMD执行副总裁,直接向苏姿丰汇报。这笔交易中,AMD既是买家,又是被收购公司的股东。
出手的不止AMD,差不多时间段内,英伟达以约129亿美元收购了全球最大的开源模型社区Hugging Face;高通收购了AI原生软件平台开发商Modular;SpaceX收购了AI编程助手Anysphere,芯片巨头们不约而同地把手伸向了模型层。
为什么AMD愿意花82亿美元买一个几乎没有营收的实验室?为什么芯片公司突然开始抢模型公司?这场争夺对中国国产芯片厂商意味着什么,摩尔线程们能不能用同样的策略?
一、一张82亿美元的船票
AMD收购World Labs这笔交易预计在2026年底前完成,仍然须要获得监管批准并满足其他惯例交割条件。
全股票方式收购意味着收购方不用筹集大量现金,AMD用新发行的股票付账即可。截至2026年6月27日,AMD的现金及现金等价物为50.86亿美元,这笔交易如果要用现金支付,AMD把账面上所有的钱全掏出来也不够。
AMD尚未确定需要发行多少股股票,发行股数将依据交割前连续10个交易日的AMD股票每日成交量加权平均价计算,计价期截至交割日前第二个交易日。
也就是说,82亿美元是当前披露的交易总价,最终稀释幅度要等交割临近时才能确定。在交割前的这段时间里,AMD股价的每一次波动,都在改变这笔交易的真实价格。
很容易联想到AMD历史上最大的一笔收购,2022年2月14日,AMD正式完成对赛灵思的收购,交易价值约500亿美元,创下了芯片领域的收购纪录。
但是2020年10月刚宣布时,对价是350亿美元,由于AMD和赛灵思股价在16个月内双双大涨,最终交易价值水涨船高,才超过了500亿美元。
既然82亿美元是暂定价格,为什么要说这笔交易难以定价?两次大额收购交易的区别在于买现在和买未来。
赛灵思是FPGA芯片的全球领导者,有着成熟的产品线、稳定的客户群和清晰的财务模型,收购赛灵思的现金流能折算出来,花销、营收、回本周期比较清楚,同时,收购完成后,AMD在CPU、GPU两大主力产品之外多了一个FPGA芯片,可以更好地跟英伟达及英特尔抢数据中心市场。
World Labs则完全不同,公司从未披露过营收,没有市盈率、没有市销率,难以折现,这笔钱在账上只能记成两样东西:无形资产和商誉。
商誉减值风险是最直接的,商誉每年要做减值测试,在世界模型技术路线没有摸索清楚之前,如何保住商誉不减值?World Labs需要花几年证明技术路线成立?
目前,有从业人士指出World Labs有被通用大模型“干掉”的风险,通用大语言模型的3D能力越来越强。如果Atlas的技术路线在AMD内部被验证为不成立,或者被通用大模型的3D能力追平,82亿美元买的是一个错误的方向。
那AMD为什么还要买?因为等不起,AMD在物理AI上几乎空白。
英伟达在物理AI这个方向已经搭建了一套完整的技术栈,客户从训练算力到仿真环境再到机器人大脑可以一站式配齐,而且配齐之后迁移成本极高。但AMD此前向公众提供的模型仍局限于文本和视频,并没有面向物理世界理解的世界模型产品。
物理AI模型要处理的是三维空间里的物体位置、距离、运动和物理约束等,World Labs研究的空间智能不仅可以补上AMD的拼图缺口,World Labs的团队在AMD内部开发下一代Atlas模型时,他们遇到的每一个计算瓶颈也都会直接变成对芯片设计的具体要求,这些要求比任何市场调研都更早、更准确。
谁能提前知道下一代工作负载长什么样,谁就能把晶体管的预算花在对的地方。
更何况基于芯片行业的特殊节奏,芯片从设计到量产要三至五年,架构两三年后才会在数据中心跑起来,如果等模型公司把新需求摆到面前再去适配硬件,芯片公司会永远慢半拍。
苏姿丰在官方声明中说,为下一代AI构建计算平台,需要深入理解模型如何演进,李飞飞和World Labs团队带来了研究领导力和模型专长。
所以,用科技分析师帕特里克·穆尔黑德的观点来总结,这笔交易的本质是一次“人才和模型洞察”的收购,AMD收购的是为未来芯片运行模型的开发人员。
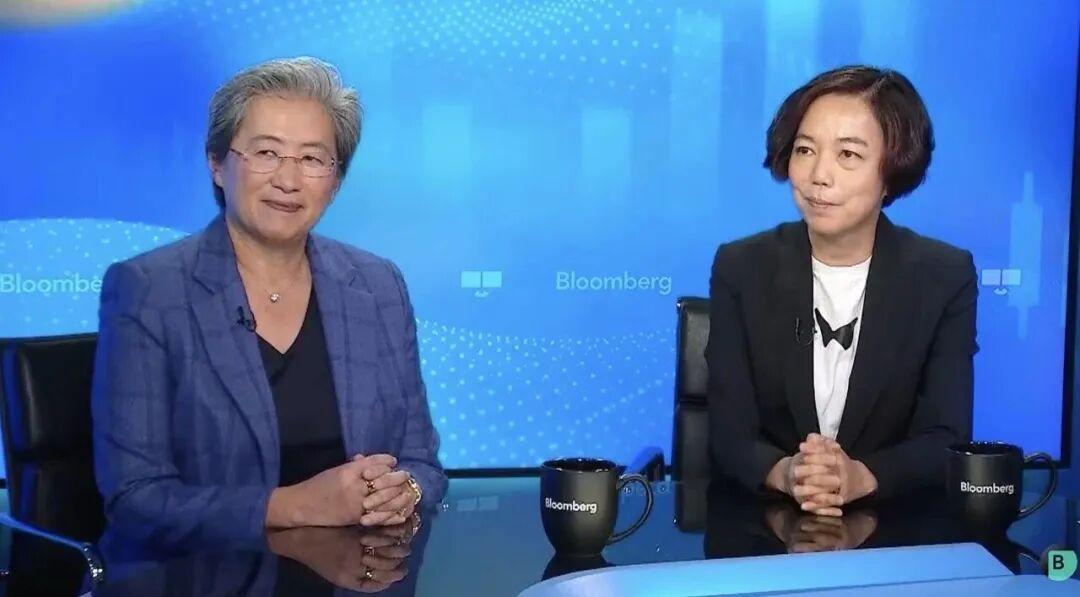
图源:腾讯科技
World Labs卖身的理由比较容易理解,交易传出的时候,李飞飞就被网友调侃“拿到大结果了”,有专业人士指出李飞飞的公司成立两年多只做了demo,根本没搞清楚世界模型到底应该怎么做。
这种质疑虽然尖锐,但反映了一个现实:世界模型创业公司自己不断去找算力、找硬件资源,倒不如直接被芯片公司收购。
李飞飞真正想做的空间智能,需要长期不计回报的投入,由于世界模型要处理视频、多视角、三维几何和实时交互,训练和推理都比大语言模型更吃算力,对面的英伟达用自家芯片喂Cosmos,谷歌用TPU喂Genie,量级完全不在一个层面。
而且,英伟达Cosmos走开放权重路线,直接压低了独立模型玩家的商业变现空间,等你做出好模型,竞争对手已经把同级别的东西免费放出来。
二、头部芯片公司完成资本站队
AMD收购World Labs的意义,更多是标志了一个更宏观的趋势:芯片巨头们开始抢模型公司了。
虽然收购的逻辑各有不同,比如,英伟达以约129亿美元收购了全球最大的开源模型社区Hugging Face,是在守住入口,买下Hugging Face等于把开发者选择模型的起点握在手里,不管开发者最后用谁的模型,最终都跑在英伟达的芯片上。
或者,AMD是在把最懂模型的AI教母请进自己家,让模型团队在芯片画图纸的早期就参与进来。
但是都指向了同一个判断:AI芯片竞争正在从谁能提供更多算力,走向谁能更早理解下一代AI需要什么样的算力。
这个判断正在重塑整个世界模型赛道的格局,收购完成后,世界模型赛道的主要玩家几乎都和某一家算力巨头绑在了一起,中立的世界模型公司正在变成稀缺品。
图源:《时代》杂志
智械岛整理了几种目前独立世界模型公司面临的不同处境。第一种,想卖身但没卖成。Decart是一家以色列世界模型初创公司,旗舰产品Oasis能以每秒20帧、零延迟渲染交互式游戏环境。
2026年8月,Anthropic被曝正在谈判以约60亿美元收购Decart,但到9月8日,彭博社报道Anthropic正式终止了这笔收购谈判。
第二种,明确拒绝被收编。General Intuition脱胎于游戏视频平台Medal,利用超过20亿条游戏视频片段训练世界模型。公司CEO确认拒绝了OpenAI据报道高达5亿美元的收购要约,选择以超过20亿美元的估值独立融资。
这是目前已知的唯一一个明确拒绝被巨头收编的独立世界模型公司。它的独立是有前提的,贝佐斯、埃里克·施密特等投资方提供了足够的资金,使其不必被迫出售。
第三种,在巨头中保持平衡。Runway原本是AI视频生成公司,2026年完成3.15亿美元E轮融资,英伟达和AMD同时参投。它没有卖身,而是在两个阵营之间保持平衡。
但这种平衡能维持多久是存疑的,随着英伟达和AMD在世界模型赛道上的竞争进一步激化,同时接受两家战略投资方的公司会面临越来越大的选边压力。
第四种,游走于各种巨头之间。2026年2月,Odyssey ML获得英伟达旗下NVentures的投资。在它的3.1亿美元B轮融资中,投资方变成了亚马逊、AMD Ventures等。
值得玩味的地方在于,把这些案例放在一起看,究其原因是独立世界模型公司在数据竞争的闭环里找不到自己的位置。
这个闭环是怎么运转的?算力决定数据,数据决定模型,模型决定定义权,而算力掌握在芯片巨头手里。
稍微展开讲:有算力的公司才能采数据,世界模型训练和仿真是算力吞金兽,实时生成高清画面往往需要多卡并行,没有足够的算力,连数据采集和预处理都跑不起来;有数据的公司才能训模型,物理AI的训练数据极度稀缺,世上没有一个现成的“物理互联网”;有模型的公司才能定义需求,当模型团队开始把硬件特性纳入架构设计的早期考量,芯片团队开始理解模型演进的方向,两边就不再是适配关系,而是共同定义关系。
定义权意味着什么?世界模型训练时,显存带宽和互联带宽哪个优先级更高;三维重建的算子应该怎么设计才能充分利用特定硬件的并行架构;物理仿真的通信模式适合什么样的集群拓扑。
这些问题的答案,如果由CUDA生态来定义,其他芯片厂商就只能跟着走。
独立创业公司在这个闭环里,每一环都被卡住,没有算力就采不了数据,没有数据就训不了模型,没有模型就参与不了定义。除非它能拿到足够的融资在某个环节建立壁垒,否则最终要么被收编,要么被边缘化。
三、摩尔线程们的另一种选择
AMD买World Labs,本质上是在已有算力底座上补上模型层,国产芯片厂商面对的局面就不同了。
以摩尔线程为例,MTT S5000采用7nm工艺,而英伟达最新的Blackwell架构已进入4nm甚至更先进节点,制程差距很大程度上决定了单卡算力上限,而世界模型对算力的需求恰恰是越多越好。
制程上的差距,意味着国产芯片需要靠集群规模化和软硬协同优化来弥补。
同时,在软件生态层面,世界模型的训练框架、算子库、通信原语,绝大多数生长在CUDA生态上。
一个模型团队如果把训练代码从CUDA迁移到国产芯片,重新调优是以月为单位的工程成本,对比模型迭代周期以周甚至以天计算。
国内真正在做世界模型底层研发的团队屈指可数,芯片厂商如果不主动建立合作,这些团队可能因为迁移成本过高而放弃国产芯片路线。
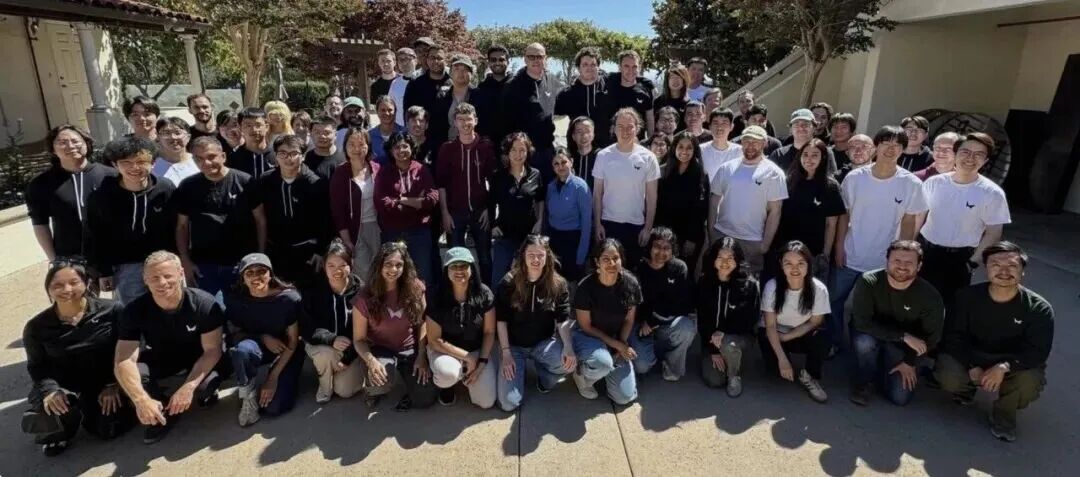
图源:腾讯科技
AMD的一次判断失误,代价可能是82亿美元的交易对价和几年的战略窗口期。国产芯片如果在这个方向上缺席,失去的可能是参与下一代算力竞争的先机。
国产芯片厂商没有AMD那样的收购能力,但可以绑定,而且绑定不只是退而求其次的选择,它在某些维度上比收购更有效,收购锁定的是所有权,绑定锁定的是协同深度。
AMD买下World Labs,李飞飞团队成为AMD员工,研究方向要服从AMD的路线图;摩尔线程与极佳视界的联合共研、与北大EvoPhys团队的全栈原生训练,可以保持各自独立性的前提下做技术路线对齐。
对于世界模型这种技术路线尚未收敛的领域,保持多路线并行探索可能比统一到一家公司的路线图下更有价值。
但绑定也有绑定的脆弱性,它没有股权关系的约束,模型团队随时可以转向其他算力平台。
绑定的路径正在从三个层次递进。
第一个层次是证明能跑。2026年2月,小马智行与摩尔线程达成战略合作,围绕小马智行的世界模型及虚拟司机系统的训练与优化展开深度协同,基于MTT S5000训推一体智算卡及夸娥智算集群推进训练适配与验证。这是小马智行首次在关键训练与仿真环节规模化应用国产AI算力。
这一层的意义不在于性能指标的高低,而在于验证了可行性的存在,打破的是国产芯片训不了前沿模型的认知惯性。
第二个层次是证明能稳定训练。北京大学EvoPhys团队的5D世界模型EvoPhys-World,在摩尔线程MTT S5000上完成了全栈原生训练,全栈原生训练意味着从第一步到最后一步都在国产芯片上完成。
世界模型的训练和语言模型根本区别在于,它需要持续一致的三维状态。如果语言模型训练崩了,重启一个checkpoint继续跑就行;世界模型训练如果状态不一致,生成的场景会在视角切换时出现结构断裂。
第三个层次是证明能定义。魔芯科技的4D世界模型MoWorld约有140亿参数,在华为昇腾NPU超节点上完成训练、压缩和部署,最高可实现约50帧每秒的实时推理,推理成本仅为同规模GPU方案的30%。
魔芯科技与华为相关团队围绕昇腾NPU开展模型训练和推理优化,形成了模型提出计算需求、芯片支撑规模部署、场景反馈推动迭代的闭环。
这一层才是定义权的雏形,模型团队开始把硬件特性纳入架构设计的早期考量,芯片团队开始理解模型演进的方向。
绑定这一小步能不能走成大路,取决于三个条件。第一,世界模型的技术路线是否会在未来两三年内收敛到一个相对稳定的架构形态。第二,国产芯片的软件栈能否从兼容层进化到原生层。第三,世界模型公司是否愿意把硬件特性纳入架构设计的早期考量,而不是训练完再考虑部署。
这三个条件中任何一个不成立,绑定就停留在能跑层面,无法走到定义层面。
四、结语
AMD用82亿美元买一张船票,国产芯片厂商正在尝试用另一种方式登船。
船票的价格很高,但船票背后的东西:对下一代算力需求的定义权,才是真正昂贵的。
封面来源:《权力的游戏》
题图来源:X账号
免责说明:文章内容仅供参考,不构成投资建议。投资者据此操作,风险自担。
本文来自微信公众号“智械岛”,作者:霍如筠,36氪经授权发布。
How we got here
- US Q3 earnings season to open with Nvidia, Micron driving growth36氪快讯 · Nvidia
- vLLM climbs GitHub Trending among Python projectsGitHub Trending · Python · Hugging Face
- Cua releases Cua Spaces 0.1.0, giving agents full desktop machinesGitHub Trending(每日) · Hugging Face
- ScanArk raises pre-seed, closing three rounds in four months36氪 人工智能 · World Labs
- Dan Ives relaunches tech coverage, bullish on Nvidia and AI's 'third inning'科技新报 · Nvidia
- Trump's new AI czar Jay Clayton heads to Silicon Valley to meet Huang and AltmancnBeta · Nvidia