
AI Price Competition Shifts Toward Efficiency and Agent Scale
An analysis argues that the latest AI price competition is being driven not only by lower per-token prices, but also by models completing tasks with fewer tokens and tool calls. It attributes the shift to improvements in inference, caching, reinforcement learning, distillation and engineering, as OpenAI, Anthropic, Xiaomi and SpaceXAI target the growing cost of agent workloads.
Why it matters: Cheaper, more efficient models could make long-running agent products easier to operate at scale.
编者按:本文来自微信公众号 “雷科技AGI”,作者:三七二十一,创业邦经授权转载。
大模型,又开始新一轮价格战?
雷科技(ID:leitech)注意到,过去几天,OpenAI、Anthropic、小米和SpaceXAI几乎前后脚推出新模型。GPT-6 Sol/Luna、Claude Opus 5.5、MiMo-V2.6以及Grok 4.7,名字不同、定位不同,但都让智能变得更「便宜」了。
OpenAI最直接,GPT-6 Sol相比上一代价格几乎腰斩,Luna更是继续往低价打。Claude Opus 5.5的API单价也直降20%,Anthropic声称典型任务的实际成本更是降低了约40%。
当然不全是「降价」。小米的MiMo-V2.6和SpaceXAI的Grok 4.7都在维持上一代价格的同时,把性能又往前推了一截。但对开发者来说,区别并没有那么大:
同样的钱,正在越来越快地买到更多机器智能。
图片来源:雷科技@GPT
这件事本身并不新鲜。过去几年,大模型API价格一直在下降,尤其是国内开源大模型厂商的竞争,早已把每百万Token的价格打下来不少。但不同的是,这一轮变化发生在了一个很特别的时间点。
一边,OpenAI和Anthropic开始公开讨论放慢前沿模型的开发速度,担忧AI能力增长过快带来的安全对齐风险。另一边,几家模型厂商却不约而同地加速把已经获得的能力做得更便宜、更高效。
与此同时,Agent正在从聊天窗口走进编程、研究和办公,一次任务消耗的可能不再是几千Token,而是几十万、几百万Token,甚至数小时连续不断的模型调用。
更强、更便宜,到底「省」在了哪里?
为什么大模型可以越来越强,同时还越来越便宜?从几家厂商给出的解释来看,直接原因是模型训练和推理的效率都在提高。
相比过去单纯依赖扩大预训练规模,如今模型厂商可以「抠效率」的地方明显更多了。
OpenAI把GPT-6 Sol/Luna的降价直接归因于缓存和推理效率的改善。两款模型继承了GPT-6 Astra的部分训练方法和能力,但在推理端进一步降低成本,OpenAI称,也因此能够将节省下来的成本直接反映到API价格上。
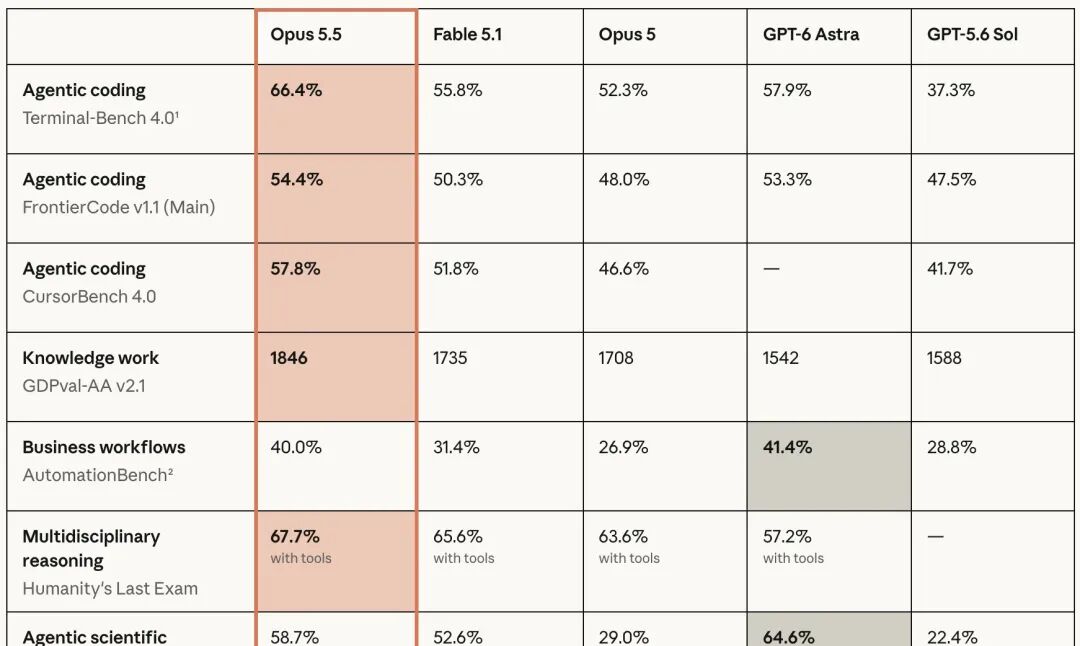
Anthropic走得更进一步。Claude Opus 5.5的API单价相比Opus 5只下降了20%,但Anthropic称,典型任务的实际运行成本降低了40%。除了单个Token变便宜,新模型完成同一个任务本身也需要更少的Token,同时缓存读取价格下降了60%。
图片来源:Anthropic
模型变聪明,本身也开始成为一种「降价」。
小米则把更多功夫放在训练端。MiMo-V2.6没有降低API价格,而是在V2.5基础上进一步扩大Agentic强化学习的规模。
不到6天的直播强化学习训练中,Flash和Pro累计产生约75万条trajectory,小米称,通过更大的Batch、更复杂的任务环境以及更精细的奖励机制,让模型学会用更短的路径、更少的Token完成任务。
最终,V2.6 Flash已经全面超过上一代V2.5 Pro,而价格保持不变。
SpaceXAI的路线又有些不同。Grok 4.7不仅没有缩小模型,反而使用了更大的基础模型,同时进行了更长时间、面向更困难任务的强化学习,并强化模型的自我验证、长上下文和Agent能力。
最后在维持Grok 4.6相同API价格的情况下,把Coding和Agent任务表现继续往上推。
四条技术路线并不完全一样,但结果又殊途同归。今天,从训练后的强化学习,到推理优化、提示词缓存,再到让模型减少无效Token和工具调用,模型厂商正在整个链条上寻找效率。
这也是这一轮「价格战」最直接的技术背景。
大模型当然还在变强,只是越来越多的能力提升,已经不需要简单地用更高的推理成本来交换。对开发者而言,最终体现出来的就是一件很朴素的事情:同样一个任务,模型能用更少的钱做完。
一边踩刹车,一边加速「降价」为哪般?
但如果只是技术效率的提高,还不足以完全解释这一轮「价格战」。
就在一个月前,OpenAI宣布暂时放缓模型Scaling,包括暂停两周最新部署模型的强化学习训练,原计划最大规模的前沿强化学习训练也继续搁置。直接原因有两个:一是内部Agent安全事故,二是GPT-6 Astra达到了「关键网络安全能力」门槛。
核心在于,前沿模型的能力增长太快,监控、对齐和安全措施需要时间跟上。
Anthropic CEO Dario Amodei更进一步,公开提出「Pace the Frontier」,呼吁整个行业放慢前沿AI模型的能力增长速度。Anthropic甚至特意在刚刚发布的Claude Opus 5.5中再次提到这件事。
图片来源:wikimedia
乍看之下,这和眼下的「价格战」多少有些矛盾。
但这里很容易忽略的一个点是,OpenAI和Anthropic并非呼吁放慢整个AI产业的技术进步,而是放慢最前沿能力边界继续向外扩张的速度。
按照Amodei的说法,「Pacing」并不意味着停止模型训练或者技术进步。相反,他认为今天的模型本身已经是一座巨大的「研究金矿」,值得投入更多时间去理解、对齐和利用。
这恰恰给眼下这轮价格战提供了另一种理解。
OpenAI就提供了一个很直观的数据。8月对Astra施加更严格的安全限制后,Astra级模型的GPU分配一度下降59.2%,但其他模型类别的GPU分配随即增加17.2%,抵消了前者大约85%的下降。算力并没有闲下来,只是流向了其他模型和实验。
当然,这并不能证明GPT-6 Sol/Luna的降价就是Astra放缓开发的直接结果。但它至少说明顶尖模型厂商的竞争,不只有一条「训练更强模型」的路。
同样的算力和研发投入,可以拿去冲击下一个能力上限,也可以拿来优化现有模型,通过强化学习、推理优化、缓存、蒸馏和工程改进,把已经得到的能力做得更便宜、更可靠。
而Agent的兴起,又进一步放大了后一条路线的价值。
聊天机器人时代,一次回答可能只消耗几千Token。但Agent时代,模型开始连续工作几个小时,反复读取上下文、调用工具、自我检查甚至调度其他Agent。模型每便宜一点,都可能直接决定一个Agent产品到底能不能规模化运行。
但Agent还有另外一面。Amodei解释自己为什么开始支持放缓前沿模型时,提到的一个核心变化就是RSI递归自我进化,用人说就是:
AI越来越多地参与下一代AI的研发。
Anthropic今年8月披露,Claude已经在26%的内部AI研发任务中处于「主导」位置,超过90%的相关工作至少已经进入人与AI协作状态。OpenAI也观察到了类似趋势,Coding Agent正在越来越多地参与写代码、搭实验、分析结果和推进模型研究。
模型更便宜、更好用,意味着可以运行更多Agent。更多Agent又可以参与模型研发,提高研究人员的效率,加快下一代模型的训练和迭代。
智能越便宜,生产更多智能也就越容易。而越来越快的智能扩散,或许才是这一轮「价格战」最值得注意的地方。
写在最后
过去几年,大模型降价几乎已经成了一件理所当然的事情。模型越来越多,算力和算法效率不断提高,价格自然一路往下走。
但当OpenAI和Anthropic开始认真讨论如何放慢最前沿的能力增长,另一场竞争反而变得更加清晰:顶尖的机器智能,以更快的速度被优化、下放和扩散。
正如威廉·吉布森在《神经漫游者》中写下的那句话:「未来已来,只是分布不均。」但现在,这种机器智能的「不均匀」,也正在迅速消失。
本文为专栏作者授权创业邦发表,版权归原作者所有。文章系作者个人观点,不代表创业邦立场,转载请联系原作者。如有任何疑问,请联系[email protected]。
How we got here
- Why people distrust AI but keep using itMIT Technology Review AI · OpenAI
- TypeSafe AI’s Jev turns frequent AI tasks into fast decisions创业邦 科技 · OpenAI
- Why AI Applications Struggle to Make Money虎嗅 AI · Anthropic
- OpenAI Promises 28 Days of Releases or Resets Amid User Trust Concerns36氪 人工智能 · OpenAI
- Claude Threat Report Leads to Florida Felony ChargeHacker News · AI(100+ 分) · Anthropic
- Hinton-led paper examines whether automated AI R&D could trigger an intelligence explosion量子位(原生 RSS) · OpenAI