
AMD收购World Labs引发4D讨论
36氪采访影身智能CEO闵伟,讨论AMD据称以约82亿美元全股票收购World Labs一事。闵伟认为,World Labs的Atlas与影身智能的相关工作表明,稀疏视角4D重建可能已进入规模化拐点;文章同时呈现了影身智能关于工业部署和性能的说法。
为什么重要:若这笔交易得到确认,将显示业界对4D世界模型及其算力需求的关注正在上升。
9月28日,一则重磅消息传来,AMD在官网宣布将以约82亿美元、全股票方式收购华裔AI科学家李飞飞创立的世界模型公司World Labs。太平洋两岸的具身智能、世界模型圈子被彻底搅动。
行业人士惊呼Amazing。World Labs成立不到两年,产品只有两个——三维场景生成平台Marble,和世界模型Atlas;公司没有披露收入,更谈不上商业模式。技术路线也远未收敛:3D空间智能派、非生成式隐空间派、平台基建派都在各自发力,没有谁被证明是标准答案。
争议几乎同步抵达:有人说这是强强联合,有人说这是“AI教母”对独立探索的背叛,但在投资人看来这笔收购或许顺理成章,因为收购方本就是其早期股东,能更清楚地了解到World Labs的实际经营情况。
与World Labs同属世界模型赛道的影身智能,则更为清楚地看到了背后的逻辑:即4D世界模型到了Scaling Up的临界点,如同此前大语言模型的发展路径一样,World Labs需要更大的算力支持以用于规模化,于AMD而言,则要提前基于4D世界模型的架构布局芯片生态。
影身智能CEO闵伟判断,在规模化的拐点之上,外加GPT-6等竞争对手的追赶,让World Labs已经没有时间像过去那样作为创业公司以小步快跑的方式做研究,而是需要转向大规模工业化。
2024年6月,前阿里巴巴机器人团队负责人闵伟在杭州创立影身智能,联合深耕动态三维重建二十余年的清华长聘教授刘烨斌。创业第一天,团队就做出一个“非主流”判断:大语言模型处理一维语言,视频模型处理二维图像,而机器人面对的是三维空间加一维时间的4D世界,用低维数据,训不出理解高维世界的智能。
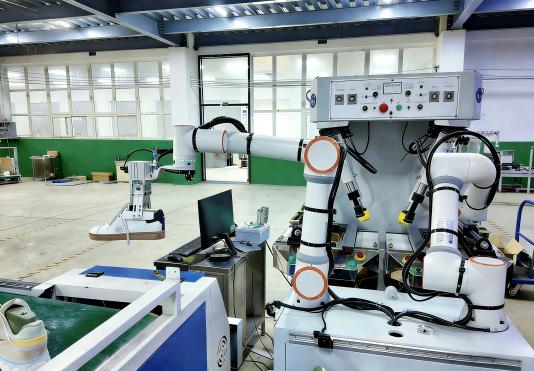
此后两年,在追求大规模数据的道路上,影身做的事是一场“减法”:把高精度4D采集设备,从80个摄像头、价值数百万元的“采集笼子”,减到4到6个普通摄像头;两台八卡服务器减到一张消费级GPU;一天的训练等待减到几十毫秒的准实时生成。基于此,今年年初,影身智能把4D世界模型搬进了制鞋工厂,让真正理解物理规律的机器人能像人一样完成涂胶、压底工作;今年9月,影身智能4D直播、4D游戏在中国国际服务贸易交易会首次亮相;同一时间段,李飞飞发布Atlas,走的是同一条稀疏视角生成4D的路线。
两条路线在太平洋两岸独立收敛,命运却并不相同。Atlas的故事停在演示里,影身已把机器人铺进鞋厂:毫米级精度、99.9%良率,45人的产线只留5个组长管40台机器人;在国内,影身智能已取得数亿元订单,在国外,首批数百台机器人出口越南、订单数千万元,“卖本体+卖Token”,埃及、土耳其、南美客户接踵而至。
AMD收购World Labs,究竟给这条路线投下怎样的信任票?“AI教母”进入大厂体系后,独立创业公司还有没有机会?4D世界模型离大规模落地还有多远?就在这笔收购发生后,我们与闵伟进行了一场对话交流,以下为经梳理后的对话实录。
82亿美元,AMD到底在买什么
36氪:看到这笔收购的消息,朋友圈里很多具身圈的人都在用Amazing形容。但说实话,我们一直有个疑问:世界模型的技术远没有收敛,AMD为什么在这么早期就下这么重的注?它为什么愿意花这样一笔钱?
闵伟: 我认为AMD下这么重的注,有两个原因。第一,AMD在之前的轮次就是World Labs的大股东、主要投资人,它对World Labs进展的了解,比我们多得多。第二,今年9月初,World Labs发布新模型Atlas。Atlas有一个很关键的突破:相对于上一代的Marble,它能够通过稀疏视角的摄像头生成4D数据。李飞飞对此进行了一个叠衣服的演示,抖开衣服,画面可以像“子弹时间”一样任意穿越,实时做4D生成。而这项技术,我们在今年4月份就已经做到了。
当时我们就判断,这个技术出来以后,能够解决4D数据大规模采集的问题。此前4D数据的采集需要很多摄像头、很长的处理时间,做不到实时,也没办法在真实场景里部署大量摄像头。当我们做到6个视角以后,就敏锐地发现:这件事可以在工业界和日常生活中去海量部署、海量采集了。海量采集这道门槛一旦迈过去,马上就会有一次大的scale up,世界模型离落地就近了,它会从前期的基础研究,转向大规模数据、大参数量模型的阶段。
所以我判断,根据我们自己对这条技术路线的理解和前期的工作,应该是Atlas发布以后,它在4D路线上海量采集的门槛也越过去了,同我们一样越过了这道门槛。AMD应该也看到了,所以火速联合起来,重金收购World Labs。可以预见,接下来它们会用工业化、大规模的方式,到真实世界里,用Atlas这种稀疏视角设备去采集海量视频,比如6个视角,甚至3个视角,再把稀疏视角视频转成4D,用4D数据去训练更强大的4D世界模型。
36氪:也就是说,正是Atlas模型在9月发布之后,这条路线的应用价值才真正有了一次大的跨越?
闵伟: 对,它从根本上解决了如何采集海量数据的问题。这是第一个原因。第二个原因,是GPT-6的发布。GPT-6发布之后会带来一个问题:传统上用视频作为训练数据的视觉模型,会受到很大挤压。
36氪:即便如此,AMD这张牌是不是下得太重了?它完全可以继续做战略投资,而不必在这么早的阶段,就把一家公司整个并入自己的体系。它们越走越近,你怎么看?
闵伟: 核心判断是,数据生成技术一旦能做到稀疏视角,就到了拐点,就可以放量了。再往后,GPT-6这样的大玩家已经追了上来,没有时间再让World Labs按照创业公司、独角兽那种小步快跑的方式继续做研究了,它要转向大规模工业化。
36氪:所以你判断,赛道已经过了0到1的拐点,马上进入1到10的阶段。
闵伟: 对,技术上已经准备好了。剩下的事,如果按它自己的节奏发展,肯定不如用大厂的重金投入来得又快又好。他们应该也能看到:Atlas既然已经发了稀疏视角,其他大厂就一定会追。所以如果他们想继续抢占先机,至少在大厂追上来的这一年时间里,提前把scale做起来,时间窗口很重要。
两年三级跳,用技术解决行业卡点
36氪:提到这一点,你之前在行业里有一个挺有名的观点:数据从来不是多少的问题,而是维度的问题。这刚好跟李飞飞的观点有点相近。影身为什么那么早就开始做4D数据?
闵伟: 从第一性原理来讲,这个世界本身就是4D的。想做视觉AI,想让它承载更多物理世界的定律,首先就要在时空维度上跟真实世界对齐。而基于视频做预训练,其实很难解决物理规律的承载问题。
比如说风。风在像素空间里是没办法建模的,它是透明的,没有RGB信息。但在4D空间里,它是空间中的流体,只是这个流体的透明度为零,其实是可以建模的。
再比如我们之前遇到的一个非常典型的问题:背景和光照变化。背景和光照变化在像素空间里属于关键特征的变化,模型只能靠加上海量数据,把这种相关性排除掉,同一个动作,配上各种各样不同的背景,让模型通过数据知道背景是不相关的、不是因果。但如果做4D,这一点就非常容易实现。还有二维世界里非常难学的遮挡、接触、穿模,在4D世界里是一目了然的。
所以从维度上讲,底层的原因是:所有真实的物理规律,都是定义在四维时空上的。用二维像素这种降维投影得到的数据去学习物理规律,是非常困难的。
36氪:影身能在4D数据领域很早实现突破,能不能给我们拆解一下,最早做这块的时候有哪些技术卡点?我们又是怎么一步步突破的?
闵伟: 对4D数据来说,2024年创业时最大的卡点,就是采集成本、硬件门槛,还有训练时长。早期我们的技术大概是用80个摄像头做高精度4D采集,需要两台八卡服务器,几分钟的数据要训练一天。当时还是用基于数学迭代优化的思路做4D生成,可以做出少量高精度数据,但没办法scale。第一,设备成本很高,80个摄像头要上百万元;第二,80个摄像头没办法在真实生产环境里大量部署,或许可以把实验性的桌面、简单场景搬进采集笼子,但真实场景比这复杂太多,不可能把生产线、机床往里搬,成本也高得离谱。
所以过去两年,我们一直致力于三件事:把摄像头的数量逐步减下来,把对算力的需求也逐步减下来。第三是把采集、训练、生成所需的时间降下来,用迭代优化、反复求解的数学办法,将原本需要一天时间才能渲染出的4D数据缩短到可实时渲染。
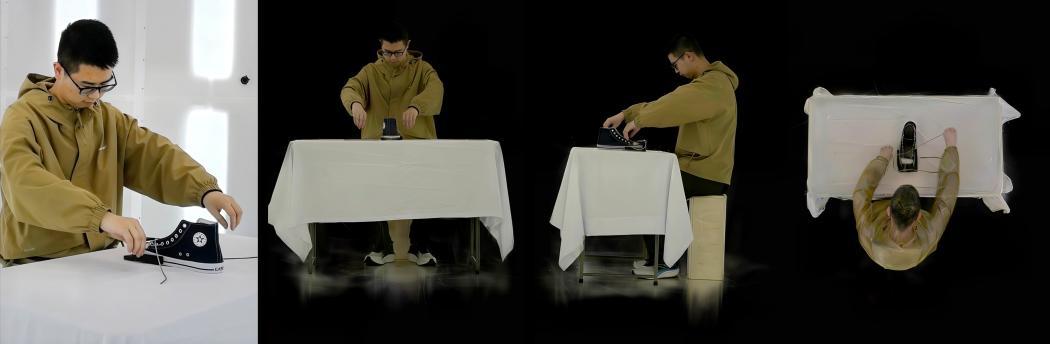
去年,我们做到了从80个摄像头变成十几个,采集训练时间从一天变成几个小时,服务器从两台变成一台,成本大大降低。今年4月,我们又有一次新的技术突破:摄像头从十几个变成4到6个,服务器用普通消费级GPU就可以,时间压缩到毫秒级,能做到准实时。当时我们先做了一个4D直播的demo,在9月份上了北京的中国国际服务贸易交易会。
到了9月中旬,我们突然发现李飞飞发布了Atlas,技术路线跟我们是一样的,也是几个稀疏视角摄像头,也是生成4D。当然,她那边是不是实时的,还有待考察。
从这个角度讲,只要能用稀疏视角做4D生成,就可以走进真实物理世界的各种场景 :家庭、工 位、车间、餐厅。加6个摄像头成本很低,对环境的要求也很低,而且是无侵入式采集,被采集对象完全没有感觉。这就具备了大规模工业化采集的可行性。
36氪:你刚才提到把摄像头数量大幅降下来。这个跨越是怎么实现的?
闵伟: 此前80个摄像头的模式,本质是一道数学公式,不带历史信息、没有先验。现在是我们自己训练一个大模型,用这个模型、用生成的办法,来实现4D的重建和生成。
36氪:行业里常用Real-to-Sim-to-Real,看起来影身不是这个路线。
闵伟: 我们没有进入Sim,是直接Real-to-Real:一个模型,6个视角的视频进去,出来就是4D。服贸会上我们展出的,就是能实时看到4D的状态。
36氪:看起来是个很不错的方案,Sim-to-Real的gap,行业一直没有解决。但想要把Sim省掉,会存在哪些难题?
闵伟: Sim-to-Real最核心的gap,恰恰就是因为Sim,把Sim省掉,自然就没有Sim-to-Real的gap了。Sim的本质是什么?是在一个人工定义的环境里做各种假设、各种简化,gap就来自这些假设和简化。
如果在隐空间里做4D特征提取,再用4D特征生成4D数据,再用4D数据去做监督,不管是机器人的具身模型还是别的模型,让隐空间里的特征尽量4D化、尽量跟真实物理世界对齐,它的幻觉问题、各种非因果的相关性建模问题,就会少很多。
Simulator最大的问题就是Sim,因为Sim一定要做各种简化。而大模型的好处,有点像当年大语言模型时代的“语法规则”。大模型时代之前,对话系统为什么泛化能力不强?就是因为有语法规则,规则本身限制了泛化。后来大语言模型做端到端、在隐空间里隐式学习,而不是靠显式规则定义,泛化能力得到了极大增强。Sim就可以当作一种显式的语法规则:那个环境里所有东西都是清晰的、人为定义的、基于规则的,规则本身就成了泛化性最大的瓶颈,也是Sim-to-Real这个gap的来源,在这种场景下做的简化是合理的,换一种场景,这个简化就不合理了。
到底该如何简化?让大模型通过隐空间去隐式学习,是更好的路径。就像语法到底是语言学家一条条写出来的,还是模型在隐空间里自己学会的?目前看,大语言模型已经证明:在隐空间里自己学会隐式语法,才有最优的泛化能力,能达到人的水平。由此我们有一个推论:在隐空间里把Sim取消掉,直接在隐空间里建模4D世界,用4D数据做监督,学会的物理规律会更贴近真实物理世界,有更好的泛化能力。
36氪:如果走这条路线,会不会碰到什么新的问题?
闵伟: 新的问题就是需要4D数据做监督,而且量要很大。从“人为写规则”变成了“用数据监督”,那就必须解决海量数据从哪里来的问题,这也是我们过去两年一直致力于解决的,如何采集海量4D数据,它变成了算法问题、工时问题、可行性问题。
走这条路线,核心就是要有海量4D数据,就要解决采集的硬件成本如何下降、如何便携地部署到真实物理世界。最近两年行业也发现,在数据中心、素材中心采的数据,能力没有那么好,还是要回到真实世界采集;还要解决无侵入式采集,整个行业最开始是遥操作,后来是UMI、用夹爪,但夹爪会干扰手;再往后是只在身上、头上戴头环。我们希望再往前走一步:头环都不用戴,只在周围加一圈环绕摄像头,用完全无感、无侵入的方式,采集真实世界海量的一手数据。
AMD收购World Labs,对4D世界模型行业是重大利好
36氪:谈到数据,现在数据采集这件事的路线实在太分散了,有人采全身数据,有人只采机械臂的数据。现在采的是哪些方面?
闵伟: 在我们的采集理念里,不管是机械臂、人体、全身还是半身,都是真实物理世界的一部分,都可以拿过来用。
只要是真实世界的一部分,它就能承载真实世界的物理规律,拿过来做4D化都可以,我们不在乎你是人体还是机器人。你只要在四维时空里受到物理规律、牛顿定律的约束,我们学习这些底层规律时,这些数据都是有用的。
所以我们的底层基座是面向4D的,不是面向某一类具体机器人的。如果面向某个具体机器人,就得想办法要么直接用这个本体去采,要么解决跨本体迁移,从人体迁到机器人。我们其实完全不在乎这一层,因为我们是更底层的4D路线。跟我们最像的,就是李飞飞的Atlas:它是4D空间的动态生成,至于那个地方是一个人在叠衣服,还是一个机器人在叠衣服,其实都没关系。
我们的应用不仅是具身,还可以用在4D直播、4D演唱会、各种时空模拟、各种引擎上,因为它是最底层的4D能力,重建、理解、生成、预测。
36氪:目前数据采集这块,具体是怎么规划的?分几步在走?
闵伟: 我们是把大模型当工具,用数据飞轮的方式。自己先有一批高精度4D数据作为启动燃料,先训出一个模型,这个模型把对摄像头的依赖从80个降到十几个,把算力需求从两台多卡服务器变成一台,训练时间从一天变成几个小时。有了这个模型,我们再利用它的能力,继续采更多4D数据。
有了新一批4D数据以后,我们再训练第二代、更强大的模型,它把摄像头从十几个变成4到6个,生成时间从几小时变成几十毫秒,服务器从多卡变成单卡。本质上还是“数据加模型”循环迭代的思路:把数据里包含的物理世界先验迁移到模型里,模型再利用这些物理先验,实现更高质量、更高效率的4D采集,最终形成一种高维数据的“冶炼”能力。
素材其实可以分成两部分:采集和加工。采集是低门槛、劳动密集型的生意;真正技术含量高的是加工环节。加工也分两个阶段:上一个时代靠人工标注,我们现在采用的是一种新的方式——把大模型本身当作数据冶炼工具,用模型实现4D数据生成,进一步降低采集门槛和对设备的需求,提升采集效率。
36氪:我注意到影身现在已经在跟一些鞋厂合作。为什么先选择了制鞋这种相对柔性的供应链?
闵伟: 选择它,是为了在真实工业产线上形成数据飞轮。高质量、高难度的数据,对模型更有价值。普通的刚性体、简单场景、简单抓取,里面包含的物理信息量是偏低的;越是柔性的、复杂的、立体的变化,包含的物理规律和物理信息越多。刚性体,可以当作柔性体的某种特殊状态。
36氪:能不能形象地描述一下,复杂场景具体难在哪?
闵伟: 比如说服装,布料的变形强依赖4D理解。布料变形的时候,表面纹理其实没什么大变化,但空间几何发生了剧烈变化。这时候基于传统二维像素的特征提取就失效了,更依赖空间几何的理解。这是非常典型的例子,类似自动驾驶里的复杂corner case,能快速提升模型对4D时空的理解。相反,桌面上摆一些刚体,水瓶、立方体、圆柱体,因为缺少材质变化,里面的物理规律就少一些,或者说比较容易学到。
36氪:最终出来的东西,精度能到什么程度?
闵伟: 精度能到毫米级。
36氪:从东盟博览会回来之后,影身的客户签约、意向的表现怎么样?
闵伟: 客户意向现在反应很热烈。东博会上就有很多东南亚的意向客户,对我们的设备非常感兴趣;还有埃及、土耳其,包括南美的客户,也来找我们对接。我们之前在越南已经签了几个大订单。国内市场,中国制鞋占了行业半壁江山,我们在晋江也有比较好的品牌和口碑。东盟博览会期间,我们跟柬埔寨工商联合总会主席、柬埔寨箱包皮革商会荣誉会长李坤泰公爵做了比较深入的沟通。李坤泰公爵一方面代表柬埔寨对华商业合作,另一方面也是柬埔寨皮革协会主席。聊完之后,他认为我们在以柬埔寨为代表的运动鞋领域会有很深入的合作,并邀请我们节后再去柬埔寨做现场调研,推动进一步合作。他是一个代表,我们跟马来西亚、新加坡,也都有类似的合作在推进。
36氪:如果让你整体概述下,影身目前的核心资产具体都包括哪些方面?
闵伟: 核心资产有几个维度。第一是数据:我们有大量私域数据,历年积累下来,加上最近在大规模采集的。第二是依托这些数据产生的“数据生产模型”,也就是我们的数据冶炼引擎,其他数据引擎是基于规则、仿真或者人工标注去编程,我们是用大模型做引擎,这是强大的生产力工具。第三,我们已经落到两个大板块:一个是4D直播,形成生态,让生态伙伴源源不断给我们生产数据;另一个,是在我们一点都不陌生的、能产生高质量物理交互和柔性交互数据的复杂产线里批量铺设,在服装鞋帽这些经典柔性操作领域形成源源不断的数据飞轮。我们在数据真实性和产业落地上,相比美国是有优势的,美国已经没有轻工业这些东西了。
36氪:AMD收购World Labs这件事,会影响到影身自己的战略发展吗?
闵伟: 这对我们其实是重大利好。此前我们的技术路线比较孤独,也花了大量时间和精力向大家解释它的可行性。一条技术路线最大的问题,就是它到底是不是主流、未来会不会成为主流,这是最大的不确定性。AMD收购World Labs,替我们证明了这件事:它用真金白银、海量投入,证明这条技术路线是可行的,是未来的方向。这对我们是最重要的。剩下的,就是去集结更多4D生态伙伴,一起把这件事做大做强。
36氪:未来两三年,影身最理想的状态是什么样?比如发布更强的模型,会有哪些指标上的提升?
闵伟: 我们现在是闭源的,计划推出开源版,中国开源版的Atlas,赋能各行各业。从我们最擅长的两个领域切入:一个是服装鞋帽的轻工业场景落地,另一个是正在大力推进的4D直播、4D互动影游、4D演唱会,进入数字娱乐产业。我们会把它作为开源的基础能力,让更多合作伙伴一起去探索4D基座模型在各行各业的应用。
前因后果
- Meta Muse热度提振AMD与IntelCNBC Technology · AMD
- 加州叫停REK人机格斗赛,Atlas换四指新手The Rundown AI · Atlas