
US appeals court: ROSS's use of Westlaw headnotes for AI training is not fair use
On Sept. 29, 2026, the US Court of Appeals for the Third Circuit upheld partial summary judgment in Thomson Reuters v. ROSS, holding that Westlaw's headnotes and Key Number system are original, copyrightable material and that ROSS's use of them to train its AI legal research tool was not fair use. The court found ROSS copied Westlaw's human-curated editorial layer — the problem-topic-case mapping — and produced a direct substitute for the same legal research market, while distinguishing the non-generative tool at issue from generative AI cases such as Bartz v. Anthropic and In re: OpenAI. Because ROSS has shut down, the case may not reach the Supreme Court.
Why it matters: It is the first federal appellate ruling on fair use in AI training, and its reasoning on intermediate training copies, direct commercial substitution and a licensing market for training data is likely to be cited in later AI copyright cases.
本文来自微信公众号: Internet Law Review ,作者:张颖
2026年9月29日,美国第三巡回上诉法院在汤森路透诉ROSS案(Thomson Reuters v.ROSS)中,维持了地区法院部分简易判决的判决:Westlaw的头注(headnotes)是具有原创性、受版权保护的内容,ROSS利用它们来训练AI法律研究工具不构成合理使用。
这是联邦上诉法院就AI训练中的合理使用问题作出的首个判决。但同时,法官在判决中明确本案的涉案工具属于非生成式,并认为“这不过是一起普通的版权案件”,将其与其他更著名的生成式AI版权案例相区分开。
鉴于初创公司Ross已经停止运营,该案可能不会被推向最高法院审理。因此,第三寻回上诉法院的判决,将可能成为这场长达6年争议的终审判决。又因为这是联邦上诉法院首次直接裁定AI培训是否构成合理使用,因此该案所形成的观点将被后续案件大量引用并形成一定的影响。
如何根据该案来评估现有产品的法律风险,将对版权者和科技公司有重大意义。
一、原创性:保护的不是“句子”,是“地图”
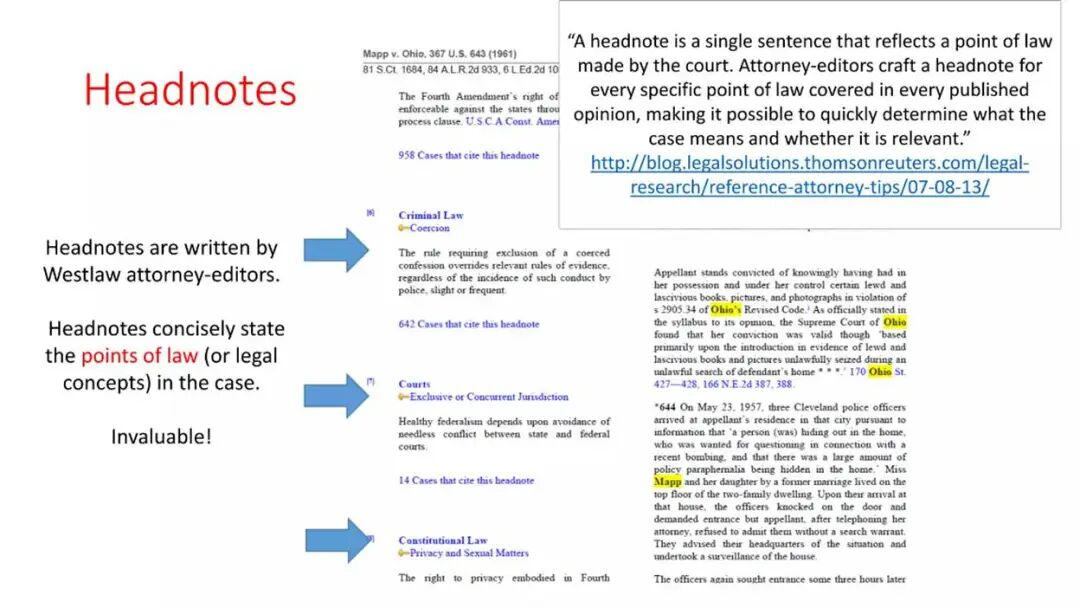
汤森路透(TR)旗下的法律研究平台Westlaw,本质上是一套“判例汇编”,拥有一套编辑撰写的头注(headnotes)和密钥编号系统:头注总结了从司法判决中提取的法律原则;密钥数字系统是一种用于分类法律主题和案件的数值分类法。点击头注即可进入司法文本中的相应段落。点击与头注关联的关键数字,会带用户进入一系列与法律观点相同的案件列表。
初创公司ROSS曾向TR申请Westlaw的使用许可,但遭到拒绝,当时TR已经意识到Ross在开发一个与其相关的竞品。于是ROSS聘请了提供法律研究和写作服务的公司LegalEase,基于Weslaw的头注和密钥编号系统创建培训数据。LegalEase据此创建了批量备忘录——一套法律问题集合,配有4-6个可能的答案。并与司法判决中经排序的段落配对。ROSS将这些备忘录转化为训练数据,用于开发其AI工具:用户以日常语言提问,AI工具可以返回现有判决中的相关段落。
美国第三巡回上诉法院判决对2,243条头注的原创性分析很克制,但方向非常清楚。
虽然法院判决本身属于“事实”,不受版权保护,但事实的表达往往受版权保护。对于每条头注,TR的编辑都做出了创造性的决定,而不仅仅是抄录判决:他们要从一份意见里判断哪些法律点值得提,哪些事实只留背景,用不超过800字符重写,使头注不读原文也能独立成立;再通过Key Number主题体系把“这个点”挂到“那一类问题”下,和大量其他判例形成可跳转的关联。
单条头注只是“标记”,头注+编号系统+跨案关联则构成了一套“地铁图”。读者用一个法律问题时,Westlaw返回的不是一个句子,而是“哪几个主题、哪些头注、哪些判例互为支撑”的路径。ROSS的AI工具学到的是Westlaw的“问题—主题—判例映射”。
这是一种专有的、人为策划的编辑层,而非底层未受保护的事实或公共领域材料。ROSS本可以从未受版权保护的司法判决中提取自己的培训标签,但它为了效率而选择了编辑层。法院直接否定了这一效率正当性:当受保护的表达本可以避免时,便利性不能在法律上替代必要性——这一判断才是本案最关键的部分。
值得注意的是,ROSS提出了三项原创性反驳,似乎也有一定道理,并在庭外也获得一些专业人士的支持,其核心逻辑是:撰写法律头注必须专业严谨地忠实于原判决,不能自由发挥,不能编造,因此编辑缺乏足够的“原创性”;头注只能按照极其有限的方式或行业标准来撰写;若对其予以保护,相当于赋予Westlaw对法律的垄断。
但法院逐一驳回,认定:同一司法意见可以有多种表达方式;头注的撰写并不存在统一的行业标准或惯例,而是体现了Westlaw编辑特有的选择和独立判断;对此予以保护,并不会妨碍他人对司法意见(事实层面)的免费使用。
既然连法律这样高度专业、以“忠实于原文”为铁律的领域,其编辑层都能获得原创性保护,那么在金融、音乐、医疗等具有更大灵活性、更多解释和发挥空间的领域,那些体现人工选择与判断的标签体系、分类图谱、知识映射,显然更可能成为受保护的内容。
因此,对于AI行业的警示是:不抄“文字”抄“分类”,同样面临巨大的法律风险。
二、合理使用:杀死ROSS的不是“训练AI”,而是“做了竞品”
在分析是否符合“合理使用”问题上,美国的版权法上有必须考量的四个因素:(1)使用目的和性质,包括是否具有商业性和变革性;(2)受版权保护作品的性质;(3)所使用的版权作品数量及其金额是否合理;(4)使用对现有或合理预期的版权作品市场的影响。
第三巡回上诉法院与地区法院的意见一致:ROSS的复制不符合合理使用标准,其分析主要聚焦于第一和第四因素,而这而这所指向的问题本质,其实都是“替代性”问题。
法院承认“用头注训练”与“把头注直接发布”相比,的确有一点形式差异,但最终目的仍是法律检索、仍是帮用户找相关判例。因为“TR和ROSS都利用这些头条创建和优化一个帮助用户找到响应性法律材料的法律研究平台”,ROSS的使用“具有相同的最终目的”,并且“充其量只是微小的变革性”。
在分析市场效应时,法院这里阐述了两个替代市场:其一是原法律检索订阅市场,ROSS做同客群同功能,当然替代;其二是“头注作为AI训练数据”的衍生许可市场,TR自己用头注训WestSearch Plus,且法院认为该市场正在快速发展;即便当时没对外授权,ROSS无偿训练也剥夺其进入该市场的机会。
这里要注意,判决不是泛泛说“只要用于训练就创造许可市场”,而是结合TR自有AI产品、头注可机读、ROSS商业竞品这些事实认定市场损害。
三、ROSS案的边界:谁在害怕合理使用变许可税?
值得注意的是,该判决并未直接回答生成式AI训练是否构成合理使用。
第三巡回法院对其裁决持谨慎态度,在脚注7中,将本案中ROSS所属的“非生成式AI”与Bartz诉Anthropic案和In re:OpenAI案中的生成式AI模型进行了区分,并据此与美国司法部在In re:OpenAI案中提交的声明相隔离——司法部宣称训练大型语言模型可以实现真正的变革性目的,因此对受版权保护的作品进行模型训练构成“合理使用”,因此OpenAI和Microsoft在训练ChatGPT于《纽约时报》文章时并未违反版权法。
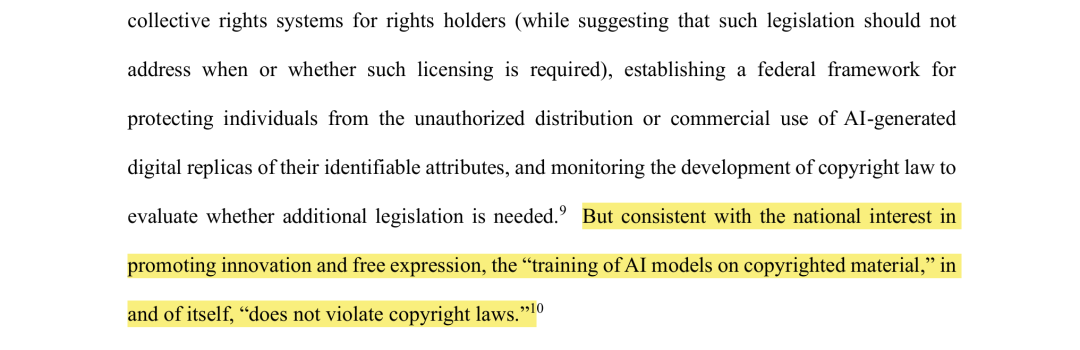
第三巡回法院实际上指出,“人工智能训练”并非本质相同的一个类别,上述DOJ的考虑以及看似相关的AI案例其实不适用于ROSS,因为ROSS的工具是非生成式的,且其复制行为建立了直接竞争替代产品。
有人认为ROSS案削弱了其他AI件中潜在的合理使用辩护,而另一些人则因其事实独特而轻视其重要性。但实际上,ROSS案是否会产生广泛影响,取决于后来法院如何解读脚注7的内容。
法院的本意,很可能是隔离其他案例或政府意见对于ROSS案的适用和影响。但,ROSS案本身却实际上建立了一个强有力的先例,很可能改变未来AI版权案件(包括生成式AI)的审理范围,它不是简单的是或否的问题,而是涉及一系列的问题:AI训练中复制了什么,如何获得,为什么需要这个表达,模型如何处理它,输出还是服务替代源代码,以及是否存在许可市场。
例如,以下分析或观点,很可能被其他生成式AI案例所引用:
作品只需“独立创作”并带有“最低程度的创造性”即可获得版权保护;
即使受保护文本从未出现在输出中,中间培训副本也可能构成侵权;
直接商业替代成为决定性因素;
新兴的人工智能培训许可市场是一个可识别的第四因素市场。
另外,该案还存在一个非意图性后果,这也是许多类似Authors Alliance版权保护组织或专家对ROSS案提出反对意见的最根本原因:法院把“AI训练数据许可市场”证成得太容易,“合理使用”的第四因素分析就会陷入一种循环——只要版权人愿意发训练许可,就推定存在市场;只要存在市场,未授权训练就当然损害。
若AI训练总体依赖许可而非合理使用,只有最有钱的科技公司付得起规模化授权,小创业公司、高校、独立研究者会被挤出;而许可条款由大内容商和大模型公司双边协定,个体作者和公共利益反而没代表。其后果不是保护作者,而是保护大聚合商。
这个担忧在专业数据库、音乐平台、金融资讯平台等垂直领域更尖锐。
四、总结:最高院“暂不作规定”反而是最优解
美国法院在ROSS案中撇清其与其他生成式AI案件的关系,以及Authors Alliance等版权组织对该案结果的担忧,揭示了AI训练“合理使用”问题的复杂性:
把“合理使用”泛化成“凡训练都可白拿”,则编辑层、分类层、人工知识图谱这种重投入资产不被保护,长期反而没人做高质量数据;但如果把AI训练默认推成“先授权、再训练”,会形成大内容商+大模型厂的双向许可寡头,个体作者未必分到钱,初创公司(如ROSS)很可能直接出局。
这种矛盾也对应了中国最高法的态度:2026年《关于依法审理涉人工智能纠纷案件的意见》发布时,中国最高法选择训练数据版权问题选择“暂不作统一规定”,理由是:分歧大,认知还在深入变化之中,因此需要先在实践中总结经验、再完善规则。
因此,我们可以看到看到,无论是中国还是美国,在更广泛的司法层面都有这样的趋向性:不把“训练”整体定为合理使用;不把“训练”整体定为强制许可;按具体场景、数据层动态分权。
How we got here
- Google DeepMind Institute essay: AI as an 'invention of a method of invention'Google DeepMind (X) · Anthropic
- The Verge reviews Artificial, Luca Guadagnino's biting Sam Altman biopicThe Verge AI · OpenAI
- Can you trust Meta’s Muse or OpenAI’s Dots to run your life?The Verge AI · OpenAI
- Europe's Q3 venture funding hits $25B, a four-year high, with AI taking 75%Techmeme · OpenAI
- OpenAI's ChatGPT Work and Codex pass 40M weekly active usersDoNews · OpenAI
- GPT-6 rolls out to all ChatGPT users alongside a major output UI revamp36氪 人工智能 · OpenAI