OpenAI posts 722 AI-written math manuscripts, sparking verification doubts
According to a single report republished by TMTPost, Huxiu and 36Kr, OpenAI released 722 mathematics research manuscripts written by an unreleased internal model on Oct 6 (US Eastern time), grouped into 372 result categories across 17 fields, with 162 including Lean formalizations of the main results; OpenAI said each successful result consumed compute equivalent to ChatGPT Pro thinking for about three hours. Claimed results include the four-dimensional Kakeya conjecture, the unique games conjecture, Hilbert's tenth problem over the rationals and the Hodge conjecture for CM abelian varieties, but OpenAI has not published the model, prompts or full compute logs, drawing reproducibility and transparency criticism. The release follows a Sept 8 claim to have solved the Navier–Stokes Millennium Prize problem, which NYU mathematician Tristan Buckmaster and a collaborator had posted similar results for about 12 hours earlier — a priority dispute that remains unresolved; researchers also flagged at least two inconsistencies between the paper and its Lean code, and three manuscripts were withdrawn over a symbol error with 14 revised, leaving 719 listed.
Why it matters: If the results hold up under peer review, they would show frontier models can mass-produce mathematics; without the model and prompts, outsiders cannot yet judge their correctness or novelty.
References 36氪 人工智能 · 虎嗅 AI · 钛媒体
(本文作者为 数智奔流,钛媒体经授权发布)
文 | 数智奔流,作者 | 田渝,编辑 | 沈校
美东时间10月6日傍晚6点,OpenAI发布了由一款尚未公开的内部模型撰写的722篇数学研究手稿,这些手稿被归纳为17个领域的372个成果类别,其中162篇还附有主结果的Lean形式化证明。
官方表示,每项成功结果消耗的算力相当于ChatGPT Pro思考3小时。
声明的成果清单包括四维Kakeya猜想、广义黎曼猜想相关问题、唯一游戏猜想、自由群因子同构问题、有理数域上的希尔伯特第十问题、CM阿贝尔簇的霍奇猜想、马勒猜想……
然而,OpenAI在数学界以大胆宣称和缺乏透明度而闻名,这次的发布引发了相当大的质疑。

OpenAI发言人告诉《科学美国人》,公司还没有公开发布的全新模型,几乎所有的结果都是在向单个代理发出单一指令后生成的。如果属实,意味着前所未有的数学能力可能很快为普通人所用。
质疑随之而来。质疑的导火索,来自9月8日,OpenAI声称解决纳维—斯托克斯千禧年难题。
纳维—斯托克斯方程,研究的是水、空气等流体的运动,广泛应用于工程与物理。
难题的核心是:如果三维流体一开始很平稳,按照纳维—斯托克斯方程运动,它会一直保持正常、平滑,还是可能在有限时间内突然出现速度或涡旋无限大的“奇点”?
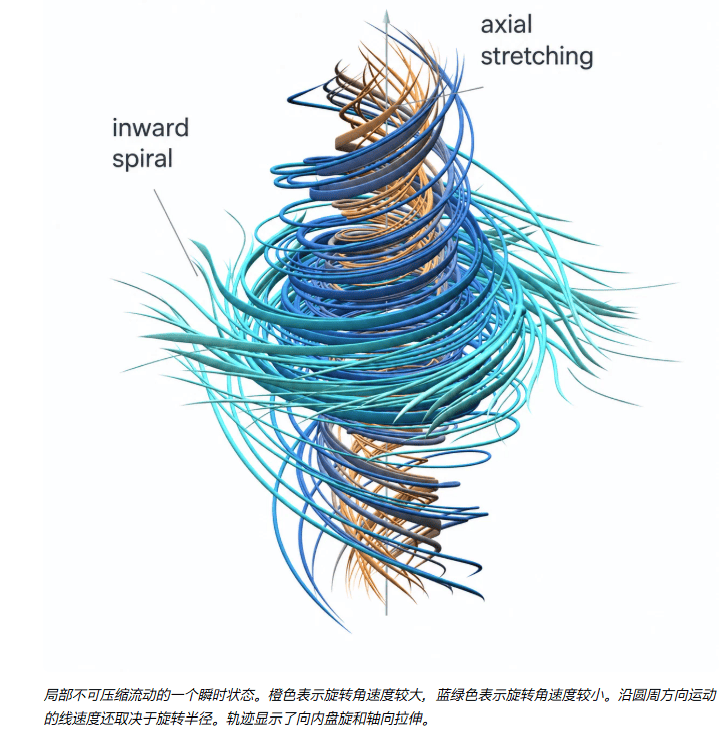
OpenAI表示,“我们的系统给出了解析证明和Lean形式化证明,表明初始静止且光滑的流体可在有限时间内产生奇点。流体受到光滑外力作用,而从静止到形成奇点的整个动力学过程中,其能量始终有限。
这一结果证明了千禧年大奖难题官方表述中的命题“C”(以及“D”)成立,从而解决了纳维-斯托克斯千禧年大奖难题。”
克雷数学研究所在2000年设立了这一难题,是全球七大悬赏难题之一,奖金100万美元。OpenAI并不打算申领奖金。
智能体系统是9月1日启动的。9月5日,首批智能体启动约88小时后,解答出炉。后来的Lean形式化验证由GPT-6 Astra完成,又花了约17小时。整个过程中,智能体共发出约490万条消息,消耗约3000亿输出token。
就在OpenAI官宣消息的12小时前,纽约大学数学家特里斯坦·巴克马斯特和他在Anthropic任职的合作者莱文特·阿尔珀格先公开了相近成果,优先权争议随之而来。
两人先后用Claude、Codex等AI模型做研究,8月15日做出关键结果,8月22日完成Lean验证。巴克马斯特表示,OpenAI是在听到传闻迅速投入大量AI代理并发布成果。
巴克马斯特认为OpenAI在成果发布、署名和优先权上处理不当,并称对方曾要求排除阿尔珀格;OpenAI否认使用他们的私人数据,称研究是独立完成的。这场优先权争议目前尚无定论。
数学家表示,领先的人工智能公司“给人一种黑帮行为的印象”。
9月21日,该公司宣布将组建一个由数学家组成的独立顾问小组,就如何负责地发布人工智能生成的计算结果提出建议。
小组建议OpenAI应该公布这个结果背后的模型、具体的提示信息和计算时间。小组尤其批评了使用“专有内部模型”的人工智能公司,因为这些模型并未向数学家广泛开放。
可是,OpenAI选择仅公布问题的平均计算时间以及一些额外的统计数据,而没有提供任何提示信息。

更大的问题在于,Lean验证并不等于这些成果已经被数学界确认。
米兰比可卡大学副教授瓦莱里奥·卡普拉罗发贴称,有最新论文研究发现,OpenAI纳维—斯托克斯方案的论文和Lean代码至少有两处不一致:
论文中的一个估计只需要四个额外的输入导数,Lean版本却需要五个,形式化结果因此更弱;论文中的压力—通量估计,也采用了不同的界限和证明方法。
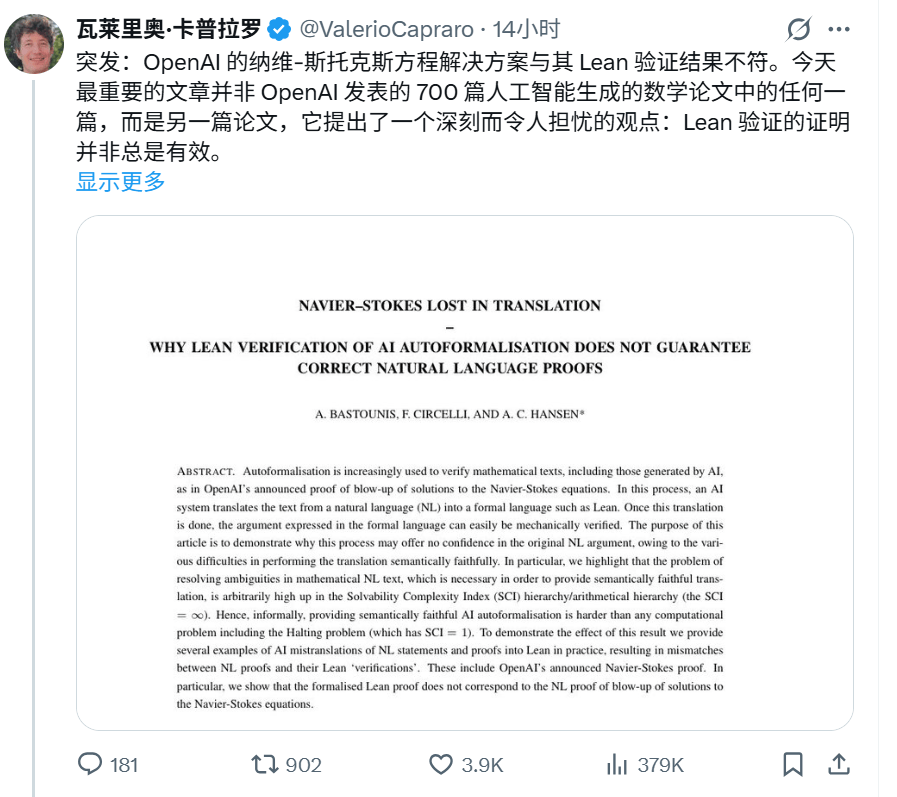
卡普拉罗表示,目前不清楚这些差异是否会使整个证明无效,但它们引出一个重要问题:OpenAI不断向我们宣称革命性突破,但没人知道这些证明是否正确,或者它们是否证明了它们声称要证明的内容。
就像卡普拉罗说的,Lean验证的能力边界正在于此。Lean只能检查这段数学推导在形式上有没有逻辑错误,判断不了它证明的内容是不是原来那个难题,也不能判断这个结果有没有真正的新意。
这也是为什么数学家要求公开完整的模型、提示词和计算过程,外界需要知道代码能否运行,需要逐项比较论文、形式化陈述和最终证明,确认三者是否指向同一个数学问题。
OpenAI公布的“平均每项结果消耗约3小时ChatGPT Pro算力”,也不能等于人工智能用3小时时间就解决了一道数学难题。
3小时只是成功保留结果的平均计算量,模型还经历了问题筛选、方向探索、反复尝试和结果整理。OpenAI的发言人也向《科学美国人》承认,部分成果可能经过多次尝试。
麻省理工学院的数学家安德鲁·萨瑟兰因此表示:“除非他们公布模型,并且人们能够复现他们的结果,否则我认为任何关于用单个智能体一次性解决问题的说法都应该被视为未经证实,”“我们应该要求他们提供证据。”

数学从来不只是获得答案。陶哲轩曾写道,在大量使用AI的时代,“记住当一个孩子是什么感觉”十分重要;在他看来,纯数学尤其依靠好奇心、探索和孩童般的惊奇。
AI正在改变数学活动的重心:当生成答案越来越容易,理解结果、提出好问题、判断其意义,并把新成果纳入人类知识体系,就变得更加重要。
这个重心正在经受“证明过剩”的考验。OpenAI在发布722篇数学手稿后,因发现一个符号错误撤回其中3篇,并修改了另外14篇;目前仓库列出719篇。
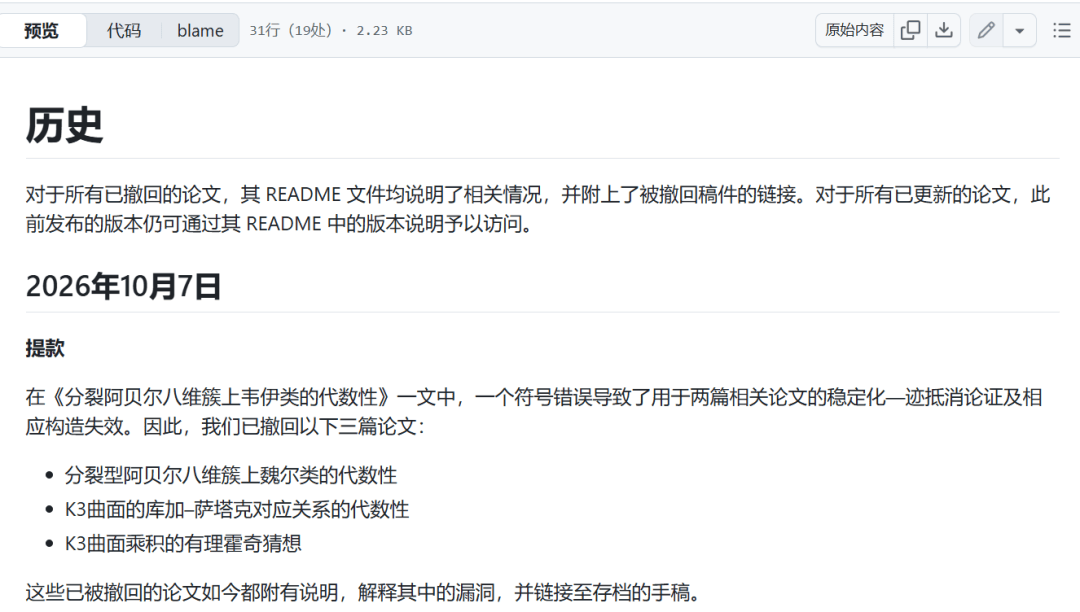
数学家们没有足够的时间逐项阅读这700多篇手稿,更何况其中很多都是上百页的证明文本。这反映出数学界对AI竞赛最深的担忧:AI正在制造“证明过剩”,偏偏人类没有足够的时间和能力去理解这些证明。
验证,从来都是整个数学研究过程中最耗人心神的环节之一。
开普勒猜想证明本身得到认可后,仍用了十多年进行形式化验证;四色定理的答案早已得到广泛接受,但如何让数学共同体信任、检查并重建计算过程,持续了几十年;有限单群分类定理的单个结论的背后是一整个需要几代人维护、修补和整理的知识网络……
OpenAI一次性放出700多篇手稿,等于把这套缓慢的消化流程压缩到了一夜之间。
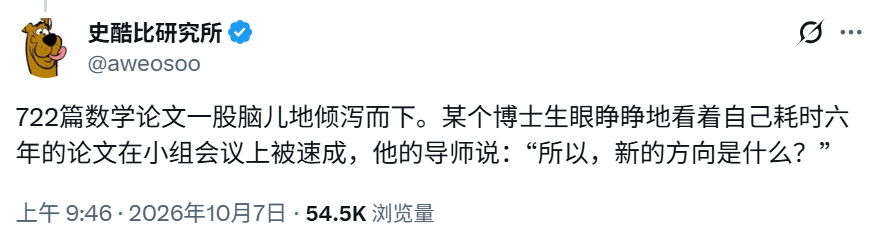
有网友把这种发布方式称为“把未经证实的工作倾倒给数学家”,也有乐观的声音认为,即使只有一半结果最终成立,这批成果仍可能改变数学研究。
“如果我们想知道这些数学问题的答案,我看不出有什么理由要求公司对我们保密,”多伦多大学数学家丹尼尔·利特说。“在我看来,这对数学发展是一件好事。”
陶哲轩及一众菲尔兹奖得主签署的《人工智能与数学的严重错位》中提到,解决问题只是数学研究的一个工具,数学更重要的目标是概念理解、理论发展、人才培养和知识传承。

OpenAI不会放慢脚步,它们希望为数学家们提供尽可能强大的工具。可是对于那些将数学真理视作目的的数学追求者来说,AI竞赛的后果难以预测。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App
How we got here
- OpenAI targets $70bn annualized revenue by year-end amid $30bn funding talksThe Next Web · OpenAI
- Report: Zuckerberg pushed to ship Meta's Muse agent despite safety concernsTechmeme · Anthropic
- OpenAI and Anthropic hire former Trump officials as AI labs court WashingtonCNBC Technology · OpenAI
- Anthropic cuts Claude Haiku 5.5 price to a tenth as OpenAI opens GPT-6 to free users36氪 人工智能 · Anthropic
- China's model labs stay quiet over the holiday as OpenAI and Anthropic keep shipping36氪 人工智能 · OpenAI
- The 8 best AI app builders for 2026, from Softr to ReplitThe Next Web · Claude