EVO-WAM:无专家示范的世界动作模型自训练
AI 总结
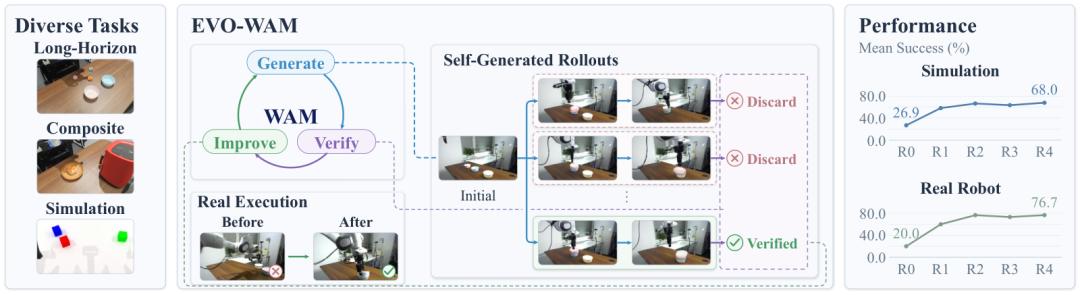
据36氪转载量子位的报道,研究团队提出 EVO-WAM,让世界动作模型自行生成完整的想象视频与动作轨迹,再用视觉语言模型判断任务是否完成、用逆动力学模型核对动作与画面是否一致,并把通过验证的片段用于微调,形成“想象—验证—学习”的迭代。团队报告称,Cosmos3 在 RoboTwin 2.0 的七个未见仿真任务上平均成功率从 26.9% 升至 68.0%,在三个未见真机长时序任务上从 20.0% 升至 76.7%(每项任务测试 10 次);DreamZero 从 28.5% 升至 46.4%。消融显示,仅用视觉语言模型筛选时第四轮为 43.7%,加入动作一致性检查后达 68.0%;作者也指出提升并非每轮单调,第三轮曾回落。
深度见解
报道称,这表明世界动作模型有望依靠自身经过验证的想象轨迹来提升未见任务表现,而无需新增专家示范,也不必把每条候选动作都放进环境试错。
不新增专家示范,也不把候选动作放进外部环境里试错,世界动作模型能否依靠自己的想象继续进化?
当前,已有部分模型能同时预测未来视频和机器人动作,并将视频预训练中积累的知识迁移到陌生任务上。然而,这些模型往往很难产出稳定表现。视频里完成了任务,配套动作却未必与画面一致,生成结果也无法直接用于训练。
EVO-WAM关注的正是这个问题:能否从模型自己生成的轨迹中找出可靠经验,用来改善它在未见任务上的表现?
它让模型自主生成完整的执行画面与动作,筛选通过验证的经验,再用这些经验训练自己,完成想象→验证→学习的循环迭代。
几轮迭代后,在基本保留已见任务性能的同时,模型Cosmos3在七个未见仿真任务上的平均成功率从26.9%提高到68.0%;在三个未见真机长时序组合任务上,从20.0%提高到76.7%。