哈佛研究:Claude在特定测试中胜过专业人类审稿
AI 总结
据字母AI、36氪和钛媒体对Gary King与Steven Worthington所领导哈佛研究的报道,研究比较了124篇论文对应的134组Claude Opus 4.8与专业人类审稿意见。Claude在七个审稿维度领先,三位前期刊编辑在30次盲评中有26次选择Claude。另一项论断核查显示,Claude意见的事实错误率为5.5%,人类为15.9%。报道也指出局限:GPT-5.5担任AI评委,样本主要涉及社会科学论文。
深度见解
该研究通过盲评、分项评分、引用与事实错误核查及稳健性检验,直接比较了AI审稿与付费专业人类审稿。其意义在于为这一特定审稿流程提供了实证依据,但AI评审偏差和以社会科学论文为主的样本限制了更广泛的结论。
哈佛拿出了能找到的最强人类审稿团,结果被Claude全线碾压!
同一批124篇论文,两边各写一份审稿意见。七个审稿维度比下来,人类一项都没赢。
3位知名期刊的前编辑被请来盲选,30次里有26次挑了Claude。有一位编辑,10组意见里一次都没选人类。
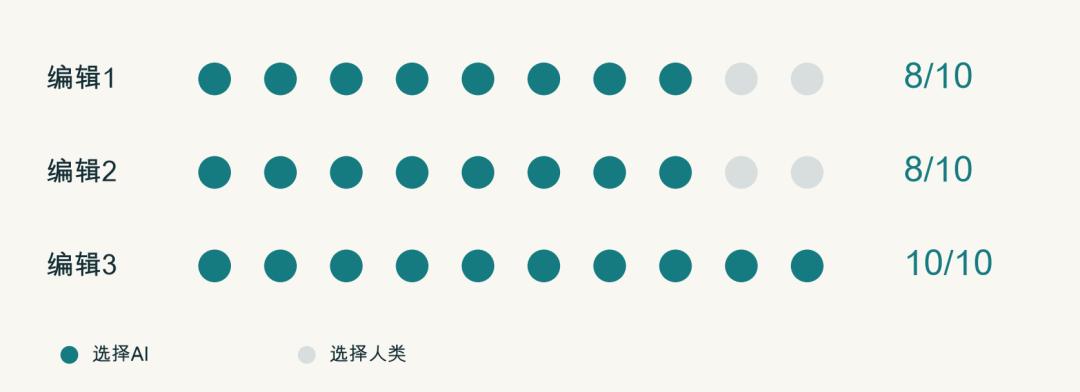
3位前编辑各比10组匿名意见,只看审稿意见,没有重读论文
就连学术圈最怕的「AI胡说」,这回也反转了。
#Harvard University#Gary King#Steven Worthington#Anthropic#Claude Opus 4.8#OpenAI#GPT-5.5#rapidPeer